The Problem of Evaluating the Effectiveness of the Miller-Rabin Primality Test
The Problem of Evaluating the Effectiveness of the Miller-Rabin Primality Test

Abstract
This work analyses the efficiency of the Miller-Rabin test. As a starting point for the analysis, the algorithm for finding a sequence of ψn numbers was chosen. Within this algorithm, a "bottle-neck" was detected and a way to solve it was presented. It turned out to be the memory consumption.
The main idea is the distribution of pseudoprime numbers over bin(ordp(ai)) values. It is concluded that the distribution is uneven and there is a strong bias towards smaller values of bin(ordp(ai)). For clarity, all reasoning and experimental results are accompanied by graphs.
Thanks to the data obtained, it was concluded that it is possible to divide the whole set of pseudoprime numbers into subsets by the value of bin(ordp(ai)). Thus, the final algorithm is produced, in which the memory consumption is optimized compared to the original algorithm.
1. Введение
Современная криптография, а особенно её защищённость, основывается на различных свойствах простых чисел. Поэтому возникает необходимость в эффективном поиске достаточно больших простых чисел. Существует множество различных подходов для решения данной проблемы. Однако наиболее известным и эффективным является использование теста Миллера-Рабина.
Таким образом, актуальность работы обеспечивается использованием простых чисел в современных исследованиях. Например, в статьях и представлен новый протокол маршрутизации, основанный на простых числах, позволяющий обнаруживать кротовые норы в мобильных сетях. Также в статьях , и представлен алгоритм шифрования, основанный на простых числах и биометрии, а также его применение в технологии блокчейна, а также его использование в интернете вещей. А в статье представлен алгоритм шифрования изображений, использующий множество простых чисел и полярное разложение.
Основной целью является исследование эффективности работы теста Миллера-Рабина и распределения его ошибки. Для достижения поставленной цели были сформулированы и решены следующие задачи:
1. Анализ существующих методов оценки эффективности теста Миллера-Рабина.
2. Анализ возможных оптимизаций для существующего метода оценки эффективности теста Миллера-Рабина.
Тест Миллера-Рабина , является вероятностным тестом. Это означает, что тест может выносить ошибочный вердикт, но с очень маленькой вероятностью. В настоящий момент известна только верхняя граница для её значения, однако она сильно завышена.
Есть и другой подход к оценке эффективности алгоритма – последовательность чисел
Таким образом, имея достаточно точную информацию об эффективности теста Миллера-Рабина, можно на его основе создавать модификации и получать достаточно точные асимптотики времени выполнения и памяти.
К примеру, К. Нари, Е. Оздемир и Н. А. Озкирисци представили алгоритм , добавляющий дополнительные проверки после запуска теста Миллера-Рабина с основанием 2. Также Д. Соренсон и Д. Вебстер разработали алгоритм по поиску наборов простых чисел по заданному паттерну . Для построения оценки эффективности они используют знания о распределении строго псевдопростых чисел.
2. Методы и принципы исследования
Тест Миллера-Рабина – вероятностный тест, представленный сперва Г. Миллером в 1976 г. , затем улучшенным М. О. Рабиным в 1980 . Основан этот тест на модификации теоремы Эйлера .
Для упрощения дальнейшего описания теорем и алгоритмов введём следующие функции:
Определение 1. Пусть n – произвольное натуральное число, представимое следующий вид:
Тогда функции bin(n) и odd(n) определяются следующим образом:
Тогда каждая итерация теста Миллера-Рабина заключается в выборе произвольного основания и проверки выполнимости следующих условий:
Если одно из условий выполнилось, то число a называется свидетелем простоты числа n, а само число считается прошедшим текущую итерацию теста.
Первый подход к оценке эффективности алгоритма основан на вычислении количества свидетелей простоты произвольного числа. Все вычисления, производимые в рамках данного подхода основаны на следующей теореме :
Теорема 1. Пусть n – произвольное натуральное число, представимое следующий вид:
Тогда выполняются все перечисленные условия:
Где за ordk(a) обозначают порядок числа a по модулю k.
Обозначим за W(n) – количество свидетелей простоты. Ш.Т. Ишмухаметов, Б.Г. Мубараков и Р.Г. Рубцова представили конечную формулу для расчёта функции W(n) для случая полупростого n=p*q:
Однако позже Б. Г. Мубараков получил формулу для произвольного числа n по его разложению на простые множители
Следующим шагом для оценки эффективности вводится функция Fr(n) – вероятность выбора свидетеля простоты. Поскольку из условий (3) следует, что НОД (a, n)=1, то значение функции будет вычисляться по следующей формуле:
М.О. Рабин доказал, что ¼ – верхняя граница для Fr(n). Однако данное значение достигается для бесконечного количества чисел n, что значительно усложняет анализ этой функции.
Поэтому оценки вычислялись для среднего значения вероятности на отрезке Avg(Fr(n)). Первая оценка для этой функции была получена Б.Г. Мубараковым, но ограничиваясь только полупростыми числами n=p*q при фиксированном p:
Однако данная оценка была сильно завышена, поэтому Б.Г. Мубараков представил улучшение оценки, но для случая p=2*p', где p' – простое число. Для этой цели рассматривались два возможных случая отношений p и q:
1. q=(p-1)k+1 → в этом случае верхняя оценка из (5) становится асимптотикой функции .
2. q=2k+1, где 2k mod (p-1) ≠ 0 → в этом случае верхняя оценка из (5) улучшается до следующей :
Наконец, посчитав математическое ожидание от обоих вариантов получаем результат :
После чего было высказано предположение, что для всех значений p оценка будет принимать следующий вид :
Где коэффициент
Также были получены результаты для трёхпростых чисел
Однако эта оценка также является сильно завышенной и требует улучшения. Одним из возможных способов разбиение всех чисел на группы, расчёт оценки для каждой группы и расчёт общего значения через математическое ожидание.
На настоящий момент получены оценки для двух классов:
1. Трёхпростое число, при фиксированном
Итоговая оценка для такой ситуации , :
2. Трёхпростое число, при фиксированном p и q, удовлетворяющих следующим условиям:
Итоговая оценка для такой ситуации :
Второй подход к оценке эффективности основан на свойствах функции
Теперь укажем теорему, на которой построена другая оценка:
Теорема 2. Пусть
Используя теорему 2 и оценки количества делителей, мы получаем верхнюю оценку для ошибки теста Миллера-Рабина, но только для полупростых чисел:
Однако реальные значения не достигают верхней оценки. Значит эту оценку можно улучшить.
Третий подход к оценке эффективности – вычисление последовательности чисел
Рассматривая уже полученные результаты, можно сделать вывод о том, что последовательность очень быстро возрастает. Однако эффективный алгоритм поиска очередного алгоритма пока не найден, поэтому поиск следующего элемента последовательности затруднителен.
Наиболее оптимальный переборный алгоритм , который использовался для поиска последних известных элементов последовательности основан на Теореме 2 и следующих утверждениях:
Утверждение 1. Если для произвольных простых чисел
Утверждение 2. Если для произвольных простых чисел
Сам алгоритм состоит из двух методов, каждый из которых выполняет перебор возможных кандидатов
Первый метод использует НОД для получения всех кандидатов. На вход метод получает число
Поскольку первый метод эффективней на маленьких числах, а второй метод на больших, то первый метод применяется для всех
Также для быстрого перебора
Таким образом итоговый алгоритм получается следующий:
Algorithm 1.
Перебираем все простые числа
Вычисляем все
Получаем список всех простых чисел из
Формируем все возможные значения
Если
Иначе, с помощью второго.
Если
3. Основные результаты
Поскольку последовательность чисел
Для начала рассмотрим распределение простых чисел на отрезке по значению
Определение 1. Пусть
Тогда функция
Эффективный поиск значения этой функции выполняется следующим алгоритмом:
Алгоритм 2.
Посчитаем
Посчитаем
Пока
Значение
Вычислительная сложность данного алгоритма
Для использования данного алгоритма докажем следующую теорему:
Теорема 3. Пусть
Доказательство. Пусть
1.
2.
Значит остаётся единственный вариант в (21).
Таким образом, заменив вычисление
4. Обсуждение
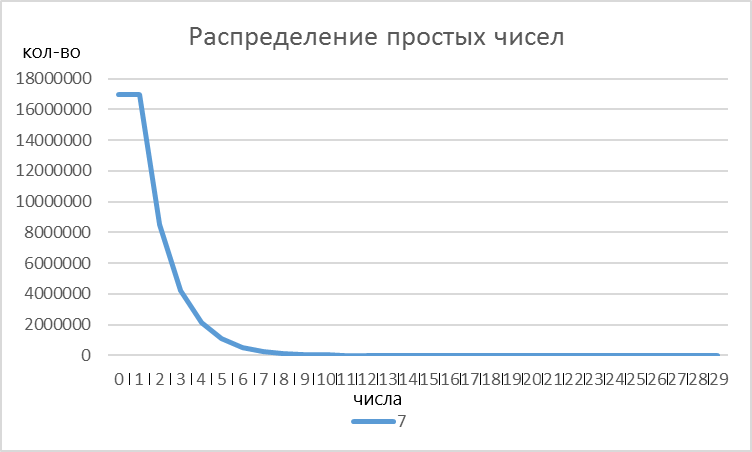
Распределение простых чисел по значениям для основания 7
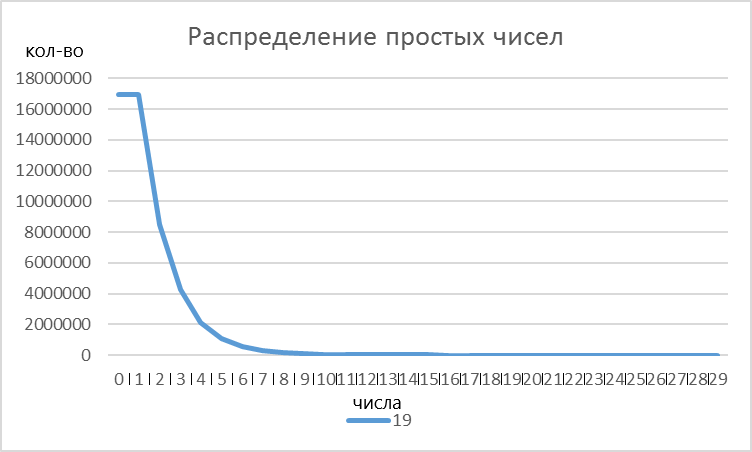
Распределение простых чисел по значениям для основания 19
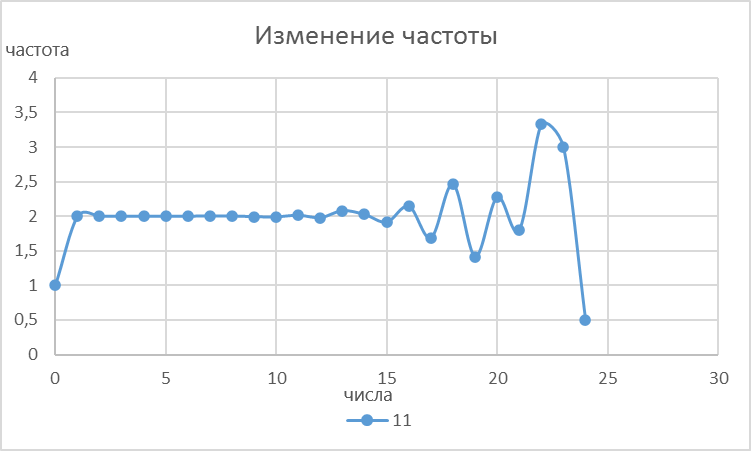
Отношение количеств простых чисел на соседних значениях
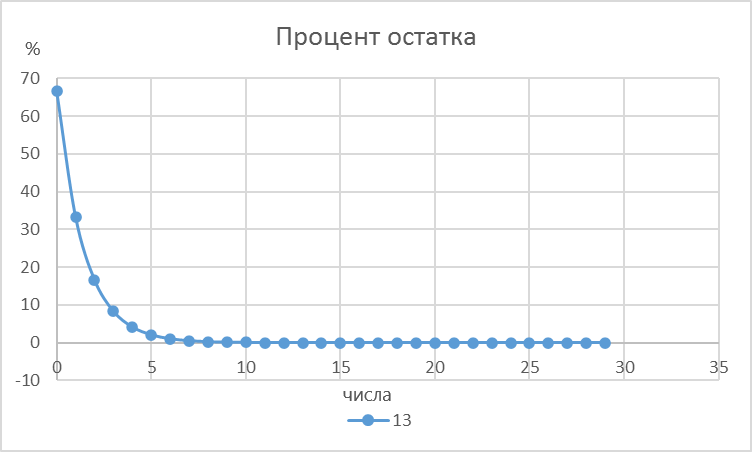
Процент оставшегося количества чисел
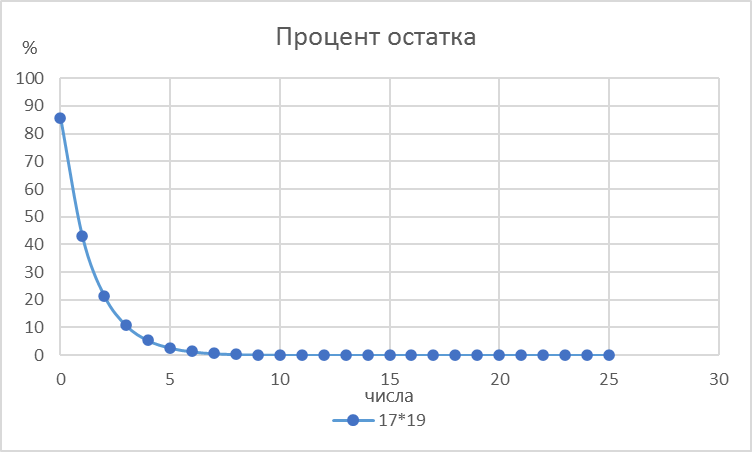
Процент оставшегося количества чисел
1 этап – перебрать все простые числа со значением всех
2 этап – перебрать все простые числа со значением хотя бы одного
Пример такого алгоритма:
Алгоритм 3.
Перебираем все основания
Очищаем все контейнеры в
Перебираем все числа
Вычисляем
Переносим
Переносим последовательно все простые числа из контейнеров
Вычислительная сложность данного алгоритма
5. Заключение
В рамках данной работы были представлены текущие результаты по оценке эффективности теста Миллера-Рабина. Было продемонстрировано три разных подхода, сделаны выводы о возможном направлении для каждого подхода. Для модификации был выбран третий подход – поиск последовательности чисел
Было обнаружено «бутылочное горлышко» для исходного алгоритма – им оказался расход памяти на хэш-таблицу. Поэтому дальнейшие исследования направлены на оптимизацию расхода памяти.
Были сделаны выводы о распределении простых чисел по значениям
Была представлена новая схема алгоритма со сравнимым временем работы, но уменьшенным расходом памяти.