Research on the depth of neural networks in the task of voice command recognition
Research on the depth of neural networks in the task of voice command recognition

Abstract
Currently artificial neural networks are actively used for tasks where the initial data is presented in the form of an audio signal. Examples of such tasks include: classifying music genres, identifying human emotions based on voice, improving the quality of audio signals (noise removal) and identifying voice commands for controlling various devices.
This study examines the task of recognizing voice commands in English using neural networks created with Keras and TensorFlow in Python. In this experiment only convolutional neural networks are used to solve the problem. The purpose of this experiment is to determine the optimal number of convolutional blocks in a neural network for high-quality command recognition.
1. Введение
На современном этапе во многих сферах применяются искусственные нейронные сети. В связи с этим исследования особенностей архитектуры и структуры таких моделей становятся довольно актуальными. Для многих задач с исходными данными в форме графической информации применяются сверточные нейронные сети, основы которых подробно освещены во многих работах:
, , . Кроме того, сверточные сети также используют и при решении задач детекции объектов на изображениях , что показывает универсальность моделей, реализующих операцию свёртки. В зависимости от особенностей решаемой задачи, параметры и количество сверточных слоев сети может существенно различаться, более подробно об этом отмечено в работах , . Помимо работы с графической информацией, сверточные нейронные сети часто применяются для задач с исходной информацией в звуковой форме, подобные задачи рассмотрены в , . В работе проведено сравнение архитектур сверточной нейронной сети, гибридной архитектуры Conformer, свёрточно-рекуррентной сети и сетей с остаточными связями (residual networks) для задач выявления эмоций и распознавания голоса. Авторами сделан вывод о предпочтительном использовании сверточных нейронных сетей в случае ограниченности вычислительных ресурсов. В исследовании предложена нейронная сеть, включающая одномерные и двумерные сверточные слои для увеличения качества распознавания речи человека. В исследовании авторы представили гибридную модель, содержащую помимо сверточных слоев блоки внимания, характерные для сетей-трансформеров, включение которых положительно влияет на качество решения задачи автоматического распознавания речи (ASR). В работе предложена свёрточно-рекуррентная нейронная сеть, включающая блоки внимания для более качественного распознавания эмоций человека по голосу. В исследовании описан эксперимент по классификации 30 голосовых команд с подбором гиперпараметров свёрточной нейронной сети. В данном исследовании в качестве предобработки данных использовано вычисление мел-частотных кепстральных коэффициентов.Таким образом изучение особенностей моделей сверточных нейронных сетей при работе со звуком является актуальной современной задачей, определившей направление нашего эксперимента.
Целью текущего исследования является выбор оптимального количества блоков сверточных слоев сети в задаче распознавания голосовых команд. В рамках исследования используется датасет “Mini speech commands”, содержащий 8 голосовых англоязычных команд: up, down, yes, no, stop, go, left, right. Мы обучим и протестируем набор сверточных нейронных сетей с разным количеством сверточных блоков слоев для выбора оптимальной модели. Актуальность данного эксперимента подтверждается активным применением архитектуры свёрточных сетей для задач распознавания речи, классификации голосовых команд, выявления эмоций и других подобных задач, описанных выше. В соответствии с поставленной целью исследования необходимо решить следующие задачи:
- создать несколько базовых моделей,
- провести обучение каждой модели,
- протестировать обученные сети на отложенной выборке,
- повторить эксперимент несколько раз,
- сравнить полученные результаты и сделать вывод об эффективности обученных моделей.
Научная новизна исследования состоит в изучении влияния глубины сверточной нейронной сети на качество классификации голосовых команд. Так как модели на основе свёрточных сетей особо актуальны для устройств с ограниченными вычислительными ресурсами (например, мобильных устройств), дополнительное изучение особенностей структуры таких моделей позволит повысить качество решения данной задачи, актуальной для массового потребления.
Практическая значимость исследования состоит в повышении качества решения задачи распознавания голосовых команд, что активно используется во многих мобильных приложениях.
Таким образом, результаты нашего эксперимента позволят более осознанно подходить к формированию структуры свёрточных сетей для решения поставленной задачи с максимальным качеством.
2. Методы исследования
Датасет “Mini speech commands”, содержащий 8000 файлов с расширением wav, был скачан с сайта
Так как в этом датасете для каждой голосовой команды имеется 1000 файлов, дополнительные шаги по корректировке баланса классов не требовались. Весь набор данных был разбит на 3 части: обучающая выборка (6400 файлов), проверочная и тестовая выборки (по 800 файлов каждая). В качестве среды для работы была использована среда Google Colab, все вычисления выполнены с использованием графического процессора T4 GPU.
В качестве предварительной обработки исходных данных использовано вычисление мел-частотных кепстральных коэффициентов (MFCC). Этот подход часто используется для предобработки звуковой информации, более подробно о его особенностях отмечено в работе
. Альтернативные подходы к предобработке звука включают построение спектрограмм, вычисление спектрального центроида, спектрального спада и других параметров, что также используется во многих исследованиях: и . Дополнительно отметим, что алгоритм вычисления MFCC может немного различаться, в зависимости от особенностей используемых инструментов. В нашем исследовании алгоритм вычисления MFCC включает следующие шаги:1. Выполнение кратковременного преобразования Фурье исходного аудиосигнала
2. Получение спектрограммы сигналов (абсолютных значений результатов преобразования Фурье)
3. Перевод спектрограммы в масштаб мел
4. Вычисление логарифмов по всем значениям мел-спектрограмм
5. Выполнение дискретного косинусного преобразования списка полученных логарифмов мел-спектрограмм.
Оценка качества работы обученных моделей проводилась с использованием метрики accuracy (доли правильных ответов классификатора), а также функции classification_report библиотеки Sklearn языка Python. Процесс обучения всех нейронных сетей проведен с использованием сокращения скорости обучения и ранней остановки процесса. Скорость обучения сокращалась в 4 раза при отсутствии улучшений метрики accuracy на проверочном множестве в течение 6 подряд эпох обучения, ранняя остановка обучения проводилась в случае, если метрика accuracy на проверочном множестве не улучшалась в течение 12 подряд итераций обучения.
Далее отметим особенности архитектуры обученных моделей.
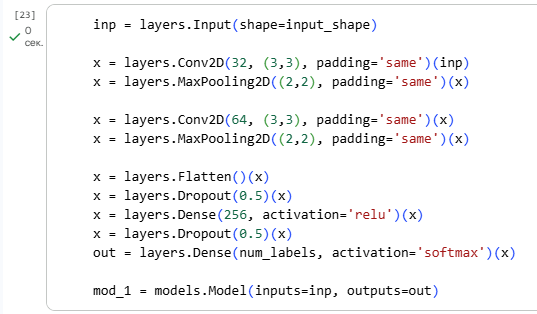
Рисунок 1 - Определение первой нейронной сети
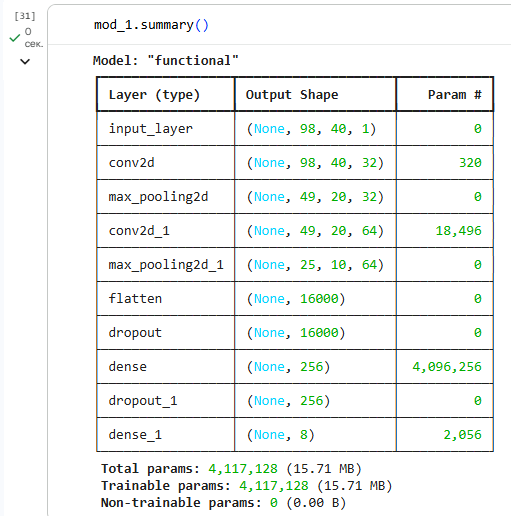
Рисунок 2 - Общая информация о базовой модели
На рисунке 2 приведена таблица, показывающая полный набор использованных слоев в базовой модели. Здесь мы также можем увидеть информацию о размерности выходных тензоров после каждого имеющегося слоя, отметим, что общее количество настраиваемых параметров модели составляет более 4,1 млн. шт.
Помимо рассмотренной базовой модели, были также определены:
· mod_2 (нейронная сеть, включающая 3 сверточных блока: 32, 64 и 128 фильтров свертки в каждом). Включает более 2,2 млн. параметров.
· mod_3 (модель, содержащая 4 сверточных блока: 32, 64, 128 и 256 фильтров свертки в каждом). Всего — более 1,7 млн. параметров.
· mod_4 (нейронная сеть, включающая 5 сверточных блоков: 32, 64, 128, 256 и 512 фильтров свертки в каждом). Содержит более 2,6 млн. параметров.
Все отмеченные выше модели отличаются между собой только количеством сверточных блоков, при этом размеры ядер свертки, подвыборки и использованные полносвязные слои нейронных сетей mod_1, mod_2, mod_3 и mod_4 — одинаковы.
При обучении всех моделей использовался метод оптимизации Adam и функция потерь “sparse_categorical_crossentropy”, так как выходные тензоры представляли собой метки классов в виде целых чисел.
3. Основные результаты
Для надежности получаемых выводов эксперимент с созданием и обучением нейронных сетей был повторен 5 раз. Для анализа полученных результатов создан объект DataFrame, где отмечены достигнутые средние значения метрики accuracy на проверочных и тестовых данных для всех нейронных сетей.
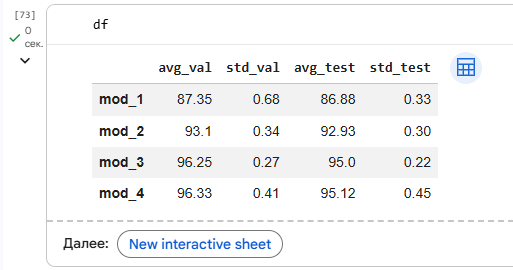
Рисунок 3 - Усредненные значения метрики accuracy и стандартные отклонения
Можем отметить, что максимальное усредненное значение доли правильных ответов на проверочном множестве (96,33%) было достигнуто моделью mod_4, при этом максимальное значение accuracy на тестовых данных для mod_4 составило 95,12%. Чуть ниже средние значения accuracy для модели mod_3 - 96,25% и 95,0% соответственно. Однако при этом, значения accuracy для mod_3 характеризуются меньшим разбросом, чем соответствующие значения метрики модели mod_4, что хорошо заметно по значениям стандартных отклонений accuracy, полученных при повторении эксперимента для mod_3 и mod_4.
Вполне очевидно, что нейронные сети с 4-мя и 5-ю блоками сверточных слоев (mod_3 и mod_4 соответственно) работают в условиях текущей задачи значительно лучше, чем модели mod_1 и mod_2. При этом разница между сетями mod_3 и mod_4 не столь велика, что говорит о том, что дальнейшее увеличение сверточных блоков для моделей уже не приносит большой полезности.
4. Обсуждение
По результатам проведенного эксперимента можем отметить, что лучшим выбором количества сверточных блоков в рамках рассмотренной архитектуры является 4 или 5 блоков. Разница по усредненной доле правильных ответов между 4 или 5 блоками совсем незначительна в пользу модели с 5-ю блоками сверточных слоев (mod_4), однако сеть с четырьмя блоками (mod_3) имеет более устойчивые значения accuracy при повторении эксперимента. Также следует отметить, что модель mod_3 имеет меньшее число настраиваемых параметров, чем mod_4 (1,7 млн. шт. вместо 2,6 млн. шт.), поэтому использует меньший объем вычислительных ресурсов. В связи с этим, mod_3 может работать и обучаться быстрее, чем mod_4.
Без проведения дополнительного исследования сложно сделать однозначный выбор между сетями с 4-ми и 5-ю блоками. Однако мы можем отметить, что эффект переобучения нейронных сетей mod_3 и mod_4 гораздо менее выражен по сравнению с моделями mod_1 и mod_2. Для более глубокого анализа результатов исследования, для всех обученных моделей также были получены отчеты по классификации тестовых аудиофайлов. Вполне очевидно, что лучшие значения метрик precision, recall и fl-score по каждой голосовой команде имеют модели mod_3 и mod_4.
Таким образом, если скорость работы и меньший объем вычислительных ресурсов имеют наиболее важное значение, то можно рекомендовать к использованию модель mod_3. В случае, когда важно максимальное качество распознавания голосовых команд, требуется проведение дополнительного эксперимента для однозначного выбора между моделями mod_3 и mod_4. Здесь следует напомнить, что путем изменения других гиперпараметров процесса обучения (начальной скорости обучения, метода оптимизации, размера батча и др.) возможно дополнительное повышение качества работы для любой из обученных моделей.
Таким образом, при использовании двумерных свёрточных слоев (Conv2D) для классификации команд по датасету “Mini speech commands” рекомендуется выбирать 4 или 5 блоков для максимизации качества работы модели. Полученный вывод вполне согласован с результатами современных исследований, например в работе
отмечена аналогичная зависимость общего количества параметров модели от качества ее работы. В нашем эксперименте структура с наименьшим количеством настраиваемых параметров (mod_3) демонстрирует близкую к максимальным значениям долю правильных ответов. Это указывает на некий оптимальный баланс между общим размером модели и качеством её работы, так как слишком простые модели будут тяготеть к недообучению, а слишком сложные — к переобучению. Также отмеченные выше моменты подтверждаются результатами исследования , где авторы отмечают склонность к недообучению модели, включающей слои Conv1D (меньше настраиваемых параметров) по сравнению с сетью, использующей слои Conv2D (больше настраиваемых параметров) в задаче распознавания речи.5. Заключение
В соответствии со сформулированной целью эксперимента, можем отметить, что при использовании датасета “Mini speech commands”, оптимальным количеством двумерных сверточных блоков является 4 или 5 блоков. Меньшее количество сверточных блоков в условиях рассмотренной задачи является менее эффективным, так как такие модели выполняют классификацию команд хуже, чем их более глубокие аналоги. Проведенный эксперимент показывает важность правильного выбора количества сверточных блоков в задаче распознавания голосовых команд и заметное влияние этого параметра на качество классификации команд.
В целом особенности выбора оптимальных параметров сверточных сетей для решения задач классификации звуковых данных мало освещены в современных исследованиях, поэтому результаты проведенного эксперимента имеют высокую практическую значимость. Особенности выбора гиперпараметров свёрточных сетей сегодня все ещё остаются малоизученными, в связи с этим проведенный эксперимент полезен для более глубокого понимания зависимости структуры модели и качества её работы.
Дополнительно отметим, что полученные выводы справедливы только в рамках выбранной конфигурации нейронной сети и процесса обучения, так как в проведенном эксперименте варьировалось только число сверточных блоков. Одним из вариантов углубления проведенного эксперимента является подбор других гиперпараметров обучения сетей с четырьмя и пятью сверточными блоками с целью максимизации доли правильных ответов моделей на новых данных.