ARCHITECTURE OF A SOFTWARE AND TOOL COMPLEX FOR MONITORING INTERACTIONS BETWEEN STUDENTS AND LLM ASSISTANTS
ARCHITECTURE OF A SOFTWARE AND TOOL COMPLEX FOR MONITORING INTERACTIONS BETWEEN STUDENTS AND LLM ASSISTANTS

Abstract
The article examines a current scientific and practical issue relating to the lack of transparency and oversight in students’ use of generative artificial intelligence in the learning process. The introduction of large language models (LLMs) into the higher education environment requires the development of specialised monitoring systems capable of recording and analysing patterns of user interaction with intelligent agents. The aim of the study is to design and provide a scientific basis for the architecture of a software and toolkit complex that enables the collection, processing and didactic interpretation of ‘student–LLM’ interaction logs. The work identifies the key requirements for the system, including scalability, personal data protection and integration with existing learning management systems (LMS). Based on an event-driven approach, a three-layer architecture for the system is suggested, comprising layers for data collection, analytical processing based on natural language processing (NLP) methods, and visualisation. An algorithm developed to calculate the Interaction Depth Index is described. The practical significance of the results lies in the creation of a technological framework for assessing the effectiveness of AI integration into the educational process, preventing academic fraud and optimising methodological support for academic disciplines.
1. Введение
Стремительное распространение систем генеративного искусственного интеллекта на базе больших языковых моделей (LLM), таких как ChatGPT, Claude, YandexGPT и GigaChat, оказало трансформирующее воздействие на высшее образование. Студенты активно делегируют интеллектуальным ассистентам широкий спектр задач: от поиска литературы и реферирования текстов до генерации и отладки программного кода. Однако неконтролируемое применение генеративного ИИ несет в себе выраженные дидактические риски: когнитивную пассивность, утрату субъектности и размывание академической честности. Административные запреты технологий показывают свою практическую неэффективность, что диктует необходимость перехода к гибкому дидактическому сопровождению и инструментальному мониторингу работы студентов с нейросетями.
В отечественной и зарубежной литературе анализ интеграции генеративного ИИ в образование ведется по нескольким направлениям:
Педагогические и этические вызовы внедрения нейросетей. В работах Н. Р. Валиахметовой, Р. М. Ахмадуллиной и И. Э. Ярмакеева систематизированы дидактические возможности и риски применения нейросетей в учебном процессе
. Н. А. Верезубова, О. А. Яковлева и О. А. Кишкинова акцентируют внимание на угрозе снижения критического мышления обучающихся и этических барьерах внедрения диалоговых агентов .Мониторинг цифрового следа и контроль самостоятельной работы. Развитие средств автоматизированного наблюдения за активностью обучающихся рассматривается в трудах А. Б. Дусткобилова, где предложены алгоритмы трекинга пользовательского поведения и компьютерного зрения для платформ дистанционного обучения
. Комплексные вызовы трансформации учебной среды под воздействием генеративного ИИ подробно освещены А. Д. Жуковым , а вопросы стандартизации и технологической безопасности применения ИИ-инструментов рассмотрены В. В. Тимченко .Когнитивные дефициты и дидактические модели работы с ИИ. На международном уровне D. Cecilio-Fernandes и J. Sandars описали феномен «галлюцинации обучения» (hallucination of learning), при котором высокая скорость получения готового сгенерированного ответа создает у студента ложную иллюзию глубокого усвоения предметного материала
. Для преодоления поверхностного потребления информации T. K. F. Chiu разработал пятиступенчатую модель решения информационных задач (AI-IPS model), задающую ориентиры критического и этического использования нейросетей .Платформы образовательной аналитики (Learning Analytics) и LLM Observability. Попытки интеграции адаптивных ассистентов в вузовские платформы представлены в исследовании J. R. Lopez, M. A. Gomez, T. K. Smith и др.
. Концептуальные рамки этичного и контролируемого использования алгоритмов ИИ в академической среде сформулированы в рекомендациях ЮНЕСКО под руководством F. Miao и W. Holmes , .Существующие системы мониторинга разделены на два обособленных класса. Системы традиционной образовательной аналитики (LMS Moodle, спецификации xAPI, IMS Caliper) фиксируют лишь поверхностные события (время сессии, просмотр страниц, факт прикрепления файла), оставляя ход мыслей и логику диалога студента с ИИ «слепой зоной». В свою очередь, инженерные платформы трассировки LLM (LangSmith, Arize Phoenix) решают узкотехнические задачи (замер latency, расход токенов, логирование ошибок API) и полностью лишены дидактического аппарата. Возникает противоречие между острой потребностью высшей школы в объективном оценивании когнитивной вовлеченности обучающихся при диалоге с ИИ и отсутствием программных архитектур, способных в реальном времени трансформировать неструктурированный текст промптов в валидные педагогические метрики.
Цель исследования — проектирование, программно-инструментальная реализация и эмпирическое обоснование архитектуры комплекса для потокового сбора, семантической обработки и дидактической интерпретации логов взаимодействия «обучающийся — LLM».
Задачи исследования:
– Сформулировать системные принципы и требования к архитектуре мониторинга взаимодействия с LLM (событийная модель, платформизделимость, Privacy-by-Design).
– Спроектировать трехслойную модульную программную архитектуру комплекса, включающую уровни сбора данных, потоковой аналитики и визуализации.
– Разработать алгоритм и математическую модель расчета интегрального индекса глубины взаимодействия (Interaction Depth Index, IDI) на основе семантического дрейфа промптов, динамики правок и времени осмысления.
– Провести экспериментальную апробацию прототипа комплекса и валидацию показателя IDI на репрезентативной выборке учебных сессий студентов IT-профиля.
2. Методы и принципы исследования
Несмотря на использование устоявшихся технологических компонентов (событийно-ориентированная шина Kafka, векторные представления BERT, формат xAPI), предлагаемое решение обладает выраженной научной новизной. Она заключается в разработке специализированного метода и программной архитектуры непрерывного трекинга семантического дрейфа диалога «обучающийся — ИИ» в режиме реального времени. В отличие от типовых систем сбора логов, оригинальный вклад авторов заключается в интеграции модуля семантической векторизации и сопоставления промптов непосредственно в конвейер обработки данных (Event Bus pipeline). Это позволяет оценивать когнитивную траекторию студента в процессе выполнения работы, а не постфактум. Нами впервые предложена модель совместного анализа временных задержек, объема заимствования текста и семантического сходства последовательных промптов, что дает возможность автоматизированно разделять плагиат и осознанную итерационную работу (prompt-scaffolding).
Проектирование архитектуры комплекса базируется на принципах системного анализа, событийно-ориентированного программирования (Event-Driven Architecture) и концепции образовательной аналитики (Learning Analytics). Методологической основой дидактической интерпретации текстовых логов выступают пятиступенчатая модель решения информационных проблем с помощью ИИ (AI-IPS)
и таксономия мыслительных навыков Б. Блума.При разработке архитектуры были сформулированы следующие системные принципы.
1. Событийно-ориентированная парадигма (Event-Driven Architecture): каждый запрос пользователя, ответ модели, сессия редактирования промпта или клик по элементам интерфейса трактуется как микрособытие, мгновенно передаваемое в шину данных.
2. Безопасность данных (Privacy-by-Design): строгое соблюдение законодательства о защите персональных данных (включая Федеральный закон № 152-ФЗ). Деперсонализация и удаление персонально идентифицируемой информации (PII) осуществляются на стороне клиентского агента до передачи текстовых данных в конвейер аналитики.
3. Платформенная независимость (API-first): обеспечение бесшовной интеграции через REST API, WebSockets и стандарт LTI (Learning Tools Interoperability) с LMS вуза, а также поддержка автономных web-клиентов.
Семантический анализ текстовых логов базируется на методах обработки естественного языка (NLP). Для расчета векторных представлений промптов и оценки семантического сходства используется предобученная модель семейства Sentence-BERT (sentence-transformers), оптимизированная для вычисления косинусного расстояния между текстовыми последовательностями.
3. Основные результаты
В ходе исследования разработана модульная трехслойная архитектура программно-инструментального комплекса мониторинга. Ее детальная блок-схема представлена на рисунке 1.
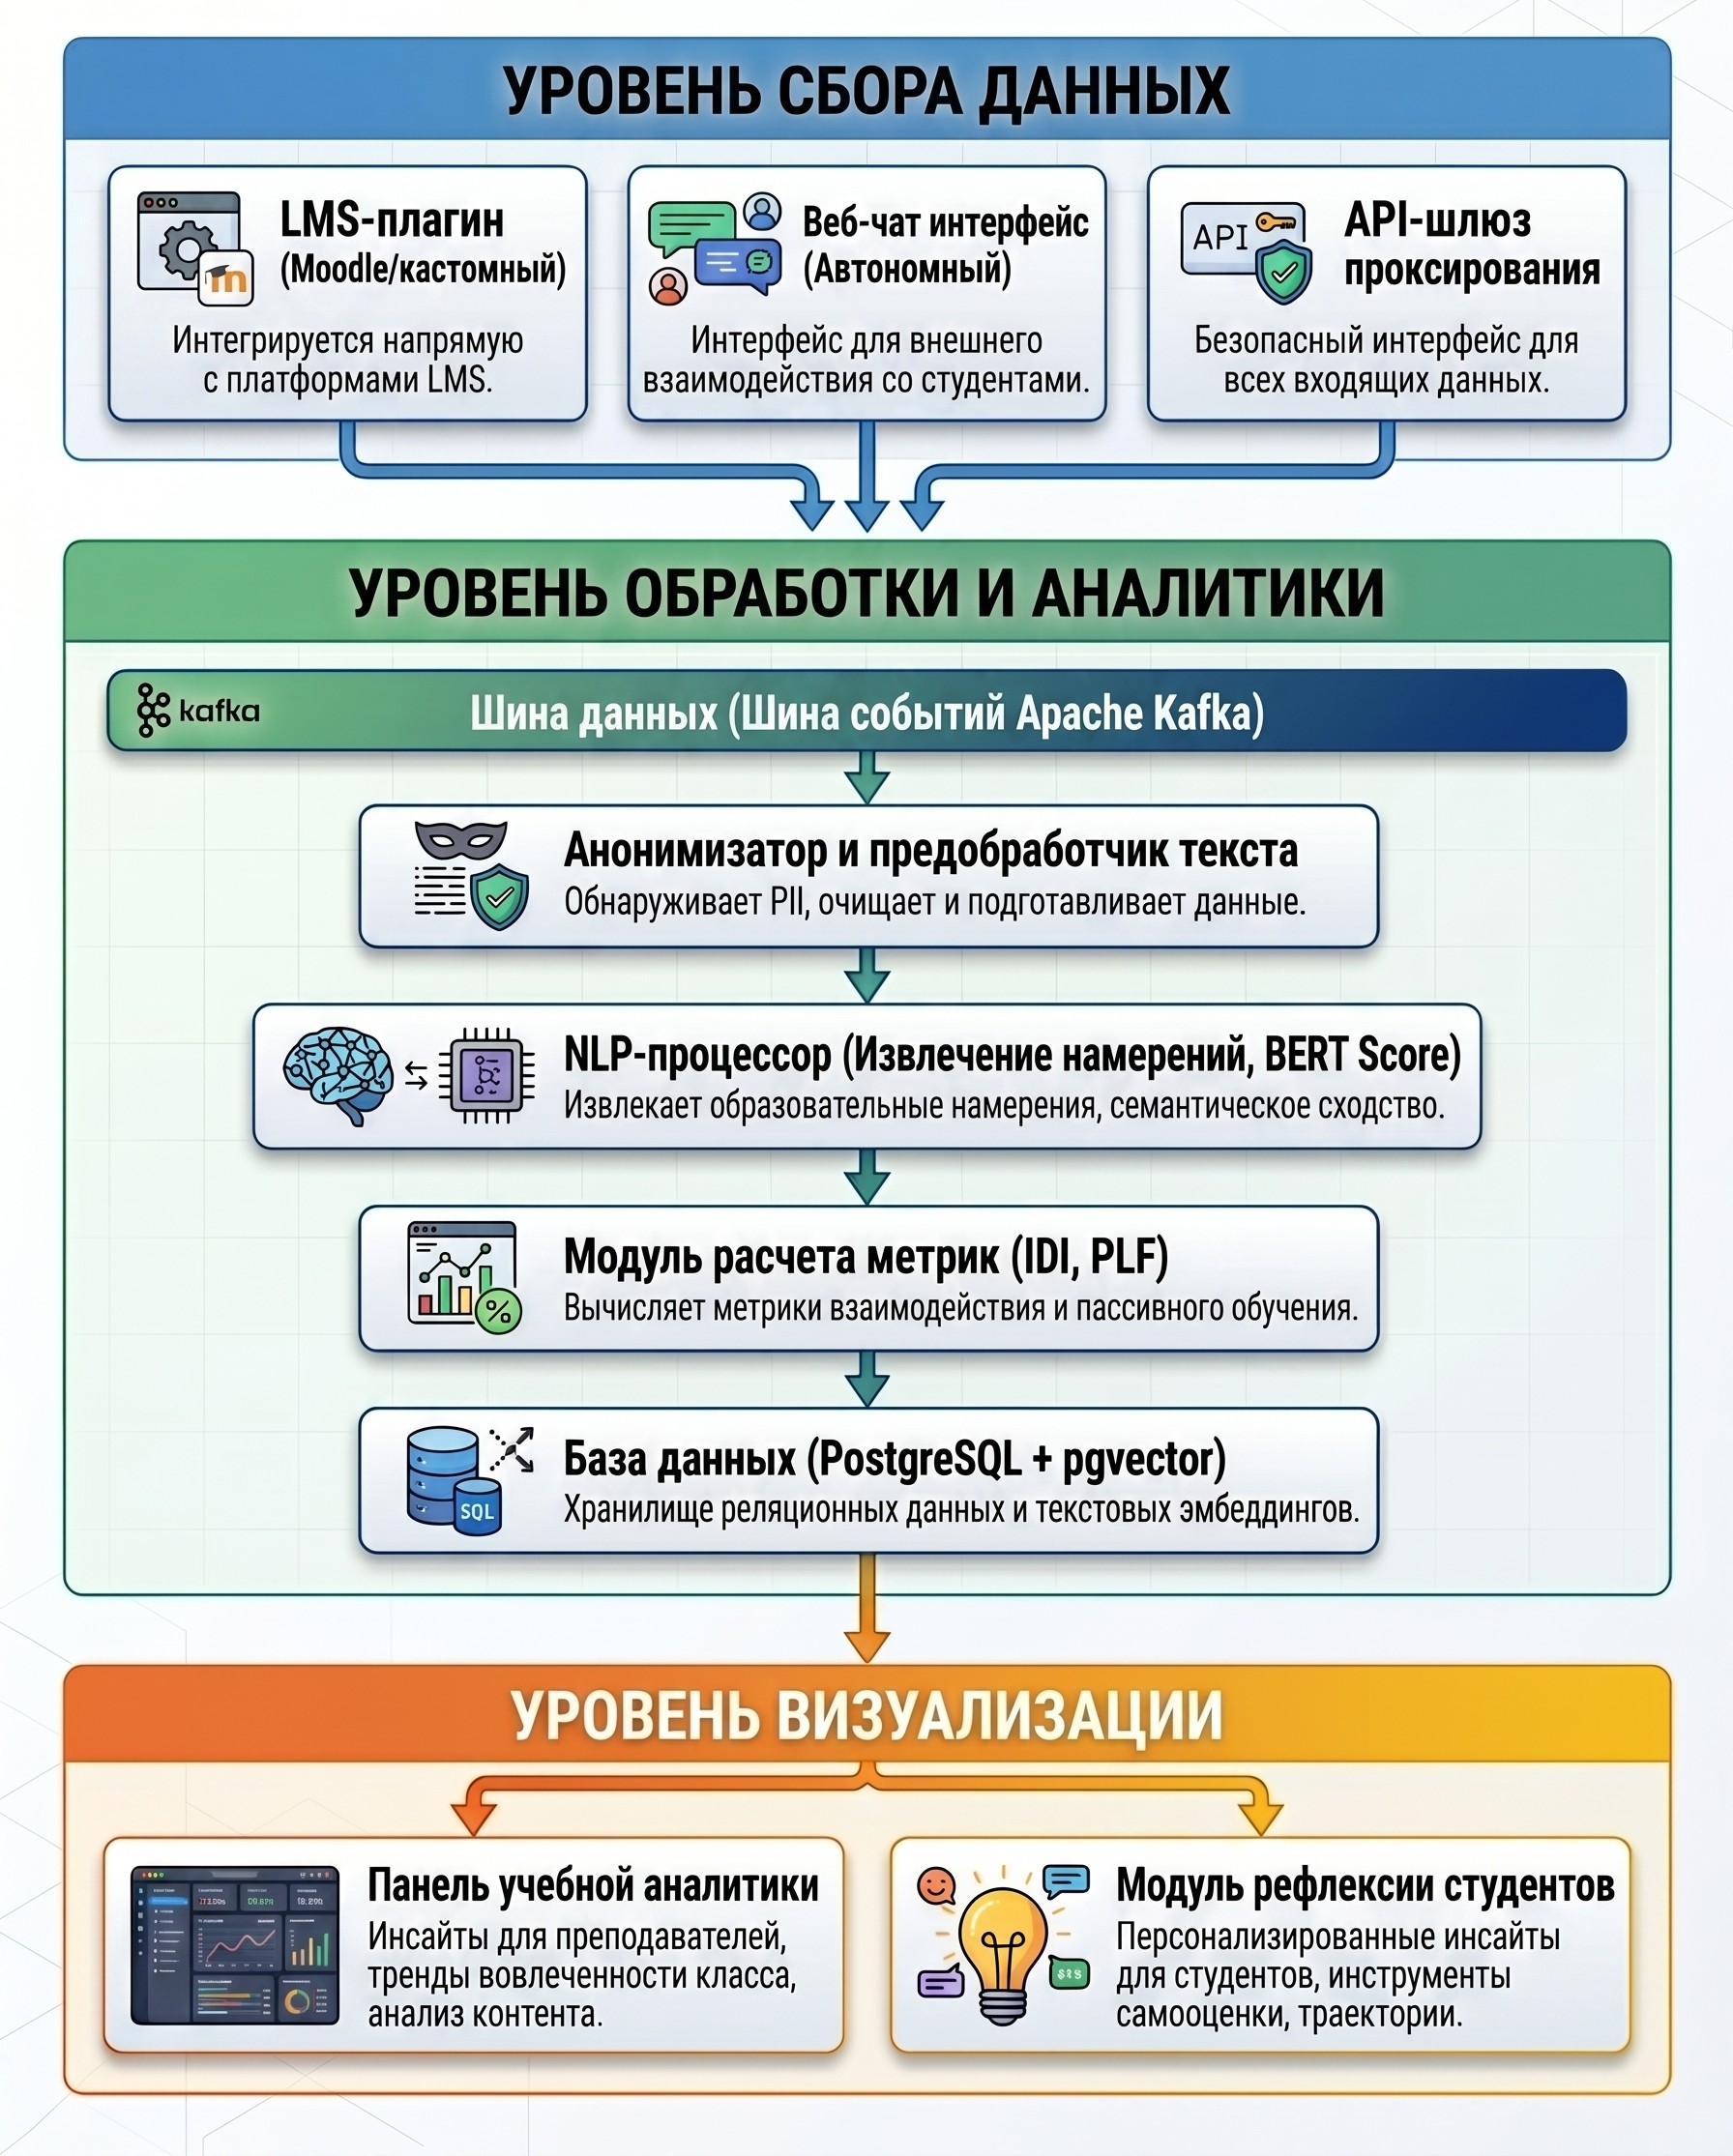
Рисунок 1 - Архитектурная схема программно-инструментального комплекса
Примечание: создано автором при помощи ИИ
1. Слой сбора данных (Data Collection Layer). Обеспечивает перехват и логирование действий пользователя. Включает плагины для стандартных университетских LMS (интеграция через REST API или WebSockets), а также автономный веб-интерфейс чата с LLM-ассистентом. Все собираемые данные приводятся к единому формату xAPI (Experience API) Extended Profile. Структура базового логируемого события представлена в таблице 1.
Таблица 1 - Структура регистрируемого события взаимодействия «обучающийся – ИИ»
Имя поля (JSON) | Тип данных | Описание и дидактический смысл |
session_id | UUID | Идентификатор учебной сессии |
timestamp | DateTime | Временная метка совершения действия |
actor_id_hash | String | Хешированный (деперсонализированный) ID студента |
event_type | Enum | Тип действия: PROMPT_SUBMIT, PROMPT_EDIT, COPY_RESULT |
prompt_text | String | Текст запроса к языковой модели |
response_text | String | Текст ответа языковой модели |
latency_ms | Integer | Время ожидания ответа от API модели |
2. Слой обработки и аналитики (Processing & Analytics Layer). Он представляет собой часть системы, которая выполняет вычисления. Данные о действиях передаются в шину сообщений Apache Kafka. С помощью этой технологии система продолжает работать, если ее используют многие люди одновременно. Когда текст очищен от персональных данных, он поступает в NLP-процессор. В этой части программы вычисляются векторы (эмбеддингов). Также программа сравнивает смысл предложений, которые вводит студент, и определяет тип его учебного поведения.
Теоретическое обоснование индекса IDI
Данная структура индекса глубины взаимодействия (IDI - Interaction Depth Index) по смыслу связана с моделью «когнитивного присутствия» (Cognitive Presence). Эта модель является частью теории конструирования знаний. Значение показателя определяется следующим методом:
Для каждого параметра в формуле есть числовое выражение, которое описывает процесс мышления:
* Параметр
* Параметр
* Параметр
Метод определения весовых коэффициентов
Настройка весов (
3. Слой визуализации (Visualization Layer). Уровень представления данных включает два специализированных интерфейса.
– Дашборд преподавателя: визуализирует агрегированные показатели когнитивной активности студенческих групп, тепловые карты семантического дрейфа и алерты об академических трудностях.
– Модуль рефлексии студента: предоставляет обучающемуся визуальную карту его собственной поисковой траектории, стимулируя развитие метапознания без применения стрессогенных методов жесткого контроля
.Эмпирическая валидация метрики
С целью верификации адекватности индекса IDI был проведен пилотный эксперимент на базе Университета «Синергия» с участием 48 студентов второго курса направления «Информационные системы и технологии». В процессе выполнения лабораторных работ по программированию было собрано 540 транзакционных сессий взаимодействия обучающихся с LLM-ассистентом на базе YandexGPT API.
Группа независимых экспертов (преподавателей кафедры) в режиме «слепого рецензирования» вручную проанализировала текстовые логи диалогов студентов и оценила уровень их реальной когнитивной вовлеченности по 5-балльной шкале. Сопоставление экспертных оценок с автоматически рассчитанным показателем IDI выявило сильную линейную связь (коэффициент корреляции Пирсона составил r = 0,78 при уровне значимости p < 0,01). Полученные данные эмпирически подтверждают, что предложенный индекс, адекватно и достоверно, в целом характеризует глубину и качество учебного взаимодействия обучающегося с языковой моделью
.
4. Обсуждение
Научно-прикладное значение предложенной архитектуры заключается в преодолении фундаментального ограничения традиционной цифровой педагогики, при котором аналитика сводится исключительно к поверхностным количественным отметкам в ущерб смысловому качественному анализу
. В отличие от распространенных решений, ограничивающихся изолированным накоплением сырых логов чата в реляционных базах, разработанный комплекс осуществляет непрерывную дидактическую интерпретацию неструктурированного потока данных непосредственно в конвейере их передачи.Анализ динамики семантической схожести промптов позволяет преподавателям оперативно диагностировать методические дефициты в структуре учебного курса. Так, систематическое возникновение идентичных уточняющих запросов у значительной доли учебной группы (более 60–70% студентов) к базовым концепциям тем указывает на пробелы или неоднозначность формулировок в основном лекционном материале, требуя адресной корректировки методического фонда.
Важным аспектом выступает соблюдение баланса контроля и автономии. Комплекс исключает механику инвазивного прокторинга, вызывающего психологическое отторжение
. Через модуль рефлексии студенты получают инструмент объективной самооценки эффективности формулирования промптов (prompt engineering).Ограничения исследования. Текущая реализация аналитического модуля зависит от лексической специфики используемой модели эмбеддингов. Корректная обработка узкоспециализированных технических запросов или профессиональных тезаурусов гуманитарных дисциплин требует дополнительной донастройки (fine-tuning) базовой языковой модели Sentence-BERT на целевых предметных корпусах.
5. Заключение
В рамках проведенного исследования получены следующие научно-практические результаты:
1. Разработана и обоснована масштабируемая модульная архитектура программно-инструментального комплекса непрерывного мониторинга взаимодействия обучающихся с генеративными LLM-ассистентами на основе парадигмы Event-Driven Architecture.
2. Реализован алгоритм сквозного семантического анализа промптов на базе модели Sentence-BERT, встроенный в конвейер шины Apache Kafka и обеспечивающий анонимизацию данных в строгом соответствии с принципами Privacy-by-Design.
3. Сформулирована математическая модель индекса глубины взаимодействия (IDI), связывающая технические характеристики диалога с уровнем когнитивного присутствия обучающегося. Весовые коэффициенты метрики верифицированы методом анализа иерархий (
4. Проведена эмпирическая валидация комплекса на выборке из 540 учебных сессий: подтверждена сильная статистическая связь расчетного индекса с экспертными педагогическими оценками (
Внедрение разработанного комплекса в цифровую экосистему вузов позволит объективировать мониторинг самостоятельной работы студентов, предотвращать академическое мошенничество на этапе генерации решений и целенаправленно развивать компетенции промпт-инжиниринга. Дальнейшие исследования авторов направлены на апробацию микросервисов комплекса в масштабных междисциплинарных потоках и тонкую настройку моделей векторных представлений под специализированные тезаурусы.