АНАЛИЗ ПОВЕДЕНИЯ АЛГОРИТМОВ ОБНАРУЖЕНИЯ И ПРЕДОТВРАЩЕНИЯ СТОЛКНОВЕНИЙ (DAA) В УСЛОВИЯХ ПУНКТА НАЗНАЧЕНИЯ ВНУТРИ ДИНАМИЧЕСКИХ ЗАПРЕТНЫХ ЗОН
АНАЛИЗ ПОВЕДЕНИЯ АЛГОРИТМОВ ОБНАРУЖЕНИЯ И ПРЕДОТВРАЩЕНИЯ СТОЛКНОВЕНИЙ (DAA) В УСЛОВИЯХ ПУНКТА НАЗНАЧЕНИЯ ВНУТРИ ДИНАМИЧЕСКИХ ЗАПРЕТНЫХ ЗОН

Аннотация
В статье исследуется критическая проблема систем управления беспилотных летательных аппаратов в условиях конфликта целеполагания, при котором конечный пункт назначения оказывается внутри динамической запретной зоны. Существующие алгоритмы обнаружения и предотвращения столкновений (DAA — Detect and Avoid) классифицируют такие цели как временно или абсолютно недостижимые, что приводит к отказам систем планирования, зависанию аппарата на границе зоны или хаотичному блужданию. В работе проводятся моделирование и анализ поведения базовых алгоритмов в данном сценарии, выявляются их системные уязвимости и формулируются требования к новому классу алгоритмов, способных оперировать пространственно-временным планированием и математическим аппаратом временных уступок. Научная новизна заключается в проведении моделирования существующих алгоритмов DAA в сценарии пункта назначения внутри динамической запретной зоны.
1. Введение
Современные алгоритмы Detect and Avoid (DAA) эффективно решают задачи уклонения от статических и непредвиденных препятствий. Однако развитие концепций городской аэромобильности и роевого интеллекта требует учета динамических запретных зон — перемещающихся областей ограничения полетов (например, подвижных погодных фронтов или зон работы спецтехники), как указано в работах , , . Наиболее сложной и малоизученной является ситуация, при которой конечный пункт назначения поглощается такой зоной. На практике подобный краевой сценарий характерен для плотного логистического трафика беспилотных летательных аппаратов (БПЛА) с общими посадочными терминалами. В этом случае аппарат получает взаимоисключающие команды: двигаться к заданным координатам и одновременно избегать их, поскольку целевая точка временно перекрыта буферной зоной безопасности другого БПЛА, освобождающего площадку, важность такого рода поведения так же указана в источниках , , .
Цель данного обзора — произвести моделирование поведения существующих алгоритмов в данном сценарии, проанализировать ограничения существующих подходов при обработке таких конфликтов целеполагания и обосновать необходимость разработки алгоритмов, способных прогнозировать поведение динамических сред и применять гибкие стратегии временной уступки.
2. Основные результаты
Методы исследования
Моделируется исследуемый сценарий, при котором ЛА оснащён системой управления поочерёдно с каждым из алгоритмов DAA, и имеет точку назначения, которая временно перекрывается запретной зоной. Запретную зону создаёт другой подвижный ЛА. Моделирование поведения алгоритмов DAA проводится в компьютерной модели, способной реализовывать любой из предложенных методов. На основе моделирования будут выделены и описаны основные паттерны поведения каждого алгоритма. Моделирование проводится в компьютерной среде, написанной на языке C++17. Параметры среды следующие: частота обновления 20ГЦ, параметр временного горизонта 2с, максимальная скорость ЛА 15 м\с и максимальное ускорение ЛА 5 м/с2. Тип Ла — мультикоптер. Моделирование, а следовательно, и сравнение, происходит без учёта шумов. Полётное задание задаётся точно, а координаты цели поступают на вход ЛА без искажений. Исследование алгоритмов с учётом шумов является отдельной, более широкой, задачей. Для каждого из сравниваемых алгоритмов было определено одинаковое полётное задание: начальная нулевая координата, точка назначения и источник запретной зоны, имеющий постоянную скорость 7 м\с. Размеры пространства ограничены 1000 метров в любую сторону. Частота дискретизации времени 0,05 секунд. В систему управления ЛА не интегрировано и не предусмотрено никаких сторонних методов принятия решений помимо исследуемых, то есть, при проведении эксперимента с конкретным алгоритмом, ЛА двигался только на основе решений этого алгоритма. Такие параметры позволяют промоделировать исследуемый сценарий с достаточной детализацией для подробного анализа. Для формирования репрезентативной научно-доказательной базы данного обзора был проведен систематический поиск профильной литературы в международных базах данных цитирования, включая IEEE Xplore, Scopus, Web of Science и Google Scholar. Поиск осуществлялся по следующим ключевым словам и их семантическим комбинациям на русском и английском языках: "UAV navigation", "Detect and Avoid (DAA)", "Dynamic No-Fly Zones (DNFZ)", "geofencing", "conflict resolution", "local minimum problem", "path planning".
Класс методов Velocity Obstacle
Методы препятствий по скорости (Velocity Obstacle, VO), описанные в работах Фьорини и Ван дер Берга , проецируют пространственные ограничения непосредственно в пространство скоростей, формируя для каждого динамического препятствия конус аварийных скоростей БПЛА. В наиболее распространенной реализации ORCA (Optimal Reciprocal Collision Avoidance) безопасный вектор вычисляется методами линейного программирования: алгоритм ищет скорость внутри выпуклой разрешенной области, имеющую минимальное евклидово расстояние до «предпочтительной скорости» (вектора цели). Однако логика ORCA не адаптирована к сценарию цели внутри запретной зоны . Поскольку целевой вектор оказывается глубоко внутри запрещенного конуса, он жестко отсекается системой. Минимизируя функцию стоимости, оптимизатор проецирует вектор движения на ближайшую границу разрешенной области, направляя БПЛА в обход препятствия строго по касательной. При этом режим ожидания (нулевая скорость) никогда не выбирается системой, так как математически евклидово расстояние от предпочтительного вектора до границы конуса всегда меньше, чем до нулевого, подробная схема такого манёвра представлена в работе Джеймса . В результате аппарат не останавливается для пропуска зоны, а уходит в бесконечное скольжение вдоль ее границы.
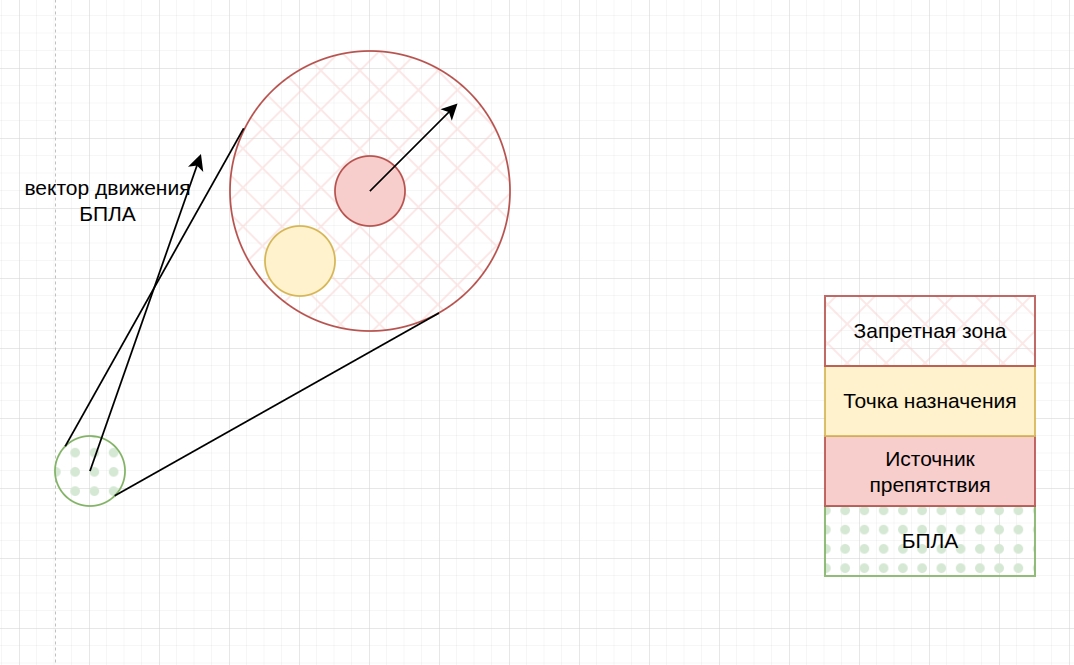
Рисунок 1 - Общая схема работы алгоритмов семейства VO
Базовая концепция APF, предложенного О. Хатибом в 1986 строится на суперпозиции притягивающего поля цели и отталкивающих полей препятствий, направляя БПЛА по вектору антиградиента суммарного поля. В сценарии, когда цель поглощена динамической запретной зоной, метод сталкивается с фундаментальным конфликтом: вектор притяжения накладывается на радиус действия мощного отталкивающего потенциала, поведение алгоритма описано в работах Варена и др. , , . Поскольку на практике весовой коэффициент препятствия задается выше коэффициента цели, равнодействующая сила либо принудительно вытесняет БПЛА в обратном направлении, либо обнуляется, формируя непреодолимый локальный минимум на границе зоны. Динамика смещения препятствия приводит к непрерывному изменению равнодействующего вектора, что вызывает хаотичные осцилляции (дрожание) аппарата вдоль фронта зоны. Ключевая уязвимость APF — исключительно реактивная природа и отсутствие 4D-прогнозирования. Оценивая градиенты только в моменте «здесь и сейчас», алгоритм не обладает математическим механизмом временной уступки, это подтверждается исследованиями алгоритма в работах , . Следовательно, стратегия безопасного ожидания (барражирования) до момента освобождения целевых координат не может быть сформирована системой естественным образом.
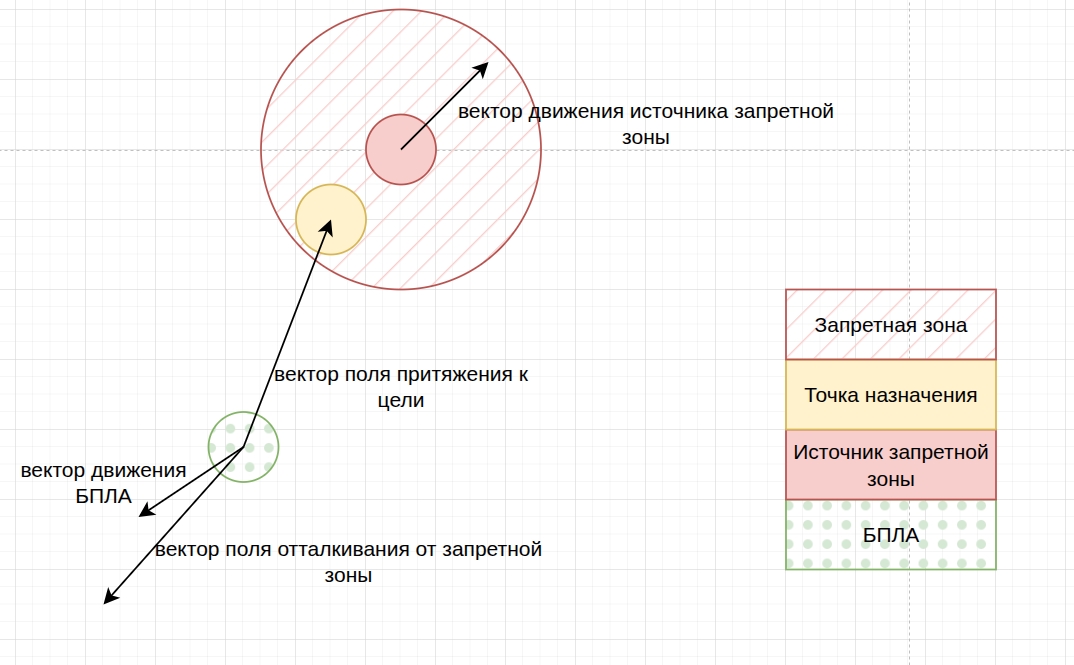
Рисунок 2 - Общая схема работы алгоритмов семейства APF
ACAS Xu — табличный метод, который является стандартом тактического уклонения, математическое ядро которого базируется на марковских процессах принятия решений с нейросетевой компрессией политик , . В отличие от непрерывных методов, система генерирует дискретные команды изменения курса. Фундаментальное ограничение ACAS Xu в рассматриваемом сценарии заключается в ее реактивной природе и полной изоляции от глобального планировщика. Модель учитывает лишь относительную кинематику объектов и не содержит переменных состояния для удержания конечной цели. Воспринимая перекрытую запретной зоной точку назначения исключительно как зону коллизии, алгоритм максимизирует вознаграждение за безопасность и радикально уводит БПЛА с маршрута серией жестких отворотов. Ключевая уязвимость состоит в том, что базовое пространство действий ACAS Xu не предусматривает режим пространственного ожидания как допустимую стратегию разрешения конфликта, это хорошо видно из работы Дейвса . Вынуждая аппарат непрерывно уклоняться от надвигающейся угрозы, система провоцирует необратимую потерю маршрута, а из-за отсутствия интеграции с глобальной миссией БПЛА не сможет вернуться к целевым координатам после их освобождения, такую же проблему описывает Пинейро .
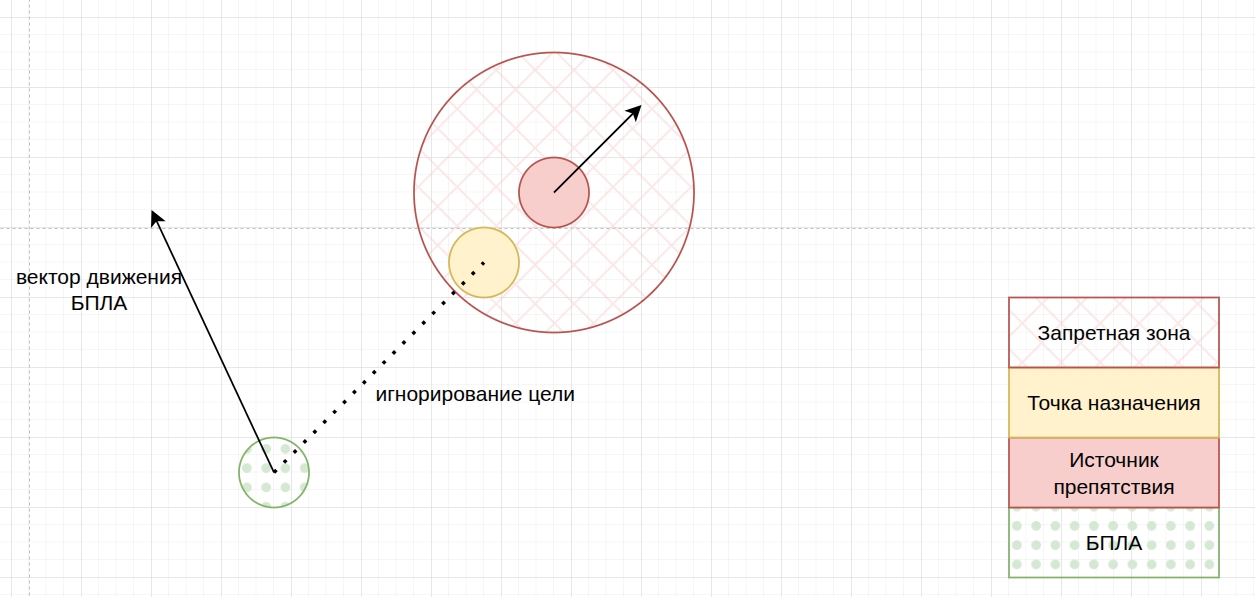
Рисунок 3 - Общая схема работы алгоритма ACAS Xu
Методы эвристического поиска на графах (A*, D* Lite) минимизируют суммарную стоимость маршрута на дискретизированной сетке пространства. В сценарии, где цель поглощена препятствием, классический алгоритм A* прерывает миссию еще на этапе предварительного расчета: стоимость целевого узла стремится к бесконечности, что делает невозможным построение непрерывного графа и вызывает ошибку планировщика. Алгоритмы непрерывного перепланирования (D* Lite), адаптирующие маршрут в реальном времени, в условиях надвигающейся динамической зоны демонстрируют критическую кинематическую неэффективность . Эвристическая функция непрерывно притягивает БПЛА к ближайшим свободным узлам на границе препятствия. Из-за движения зоны топология среды меняется на каждом такте вычислений, что провоцирует постоянную инвалидацию текущего пути и циклический перезапуск тяжелой процедуры перепланирования. Физически этот сбой выражается в эффекте «дребезга» траектории (path chattering): аппарат совершает хаотичные зигзагообразные маневры вдоль фронта запретной зоны, постоянно пытаясь нащупать проход к цели. Подобная реакция лишена стратегической логики режима ожидания — она не способствует выполнению полетного задания, но при этом вызывает существенный перерасход энергии батареи и избыточные динамические нагрузки на кинематику БПЛА .
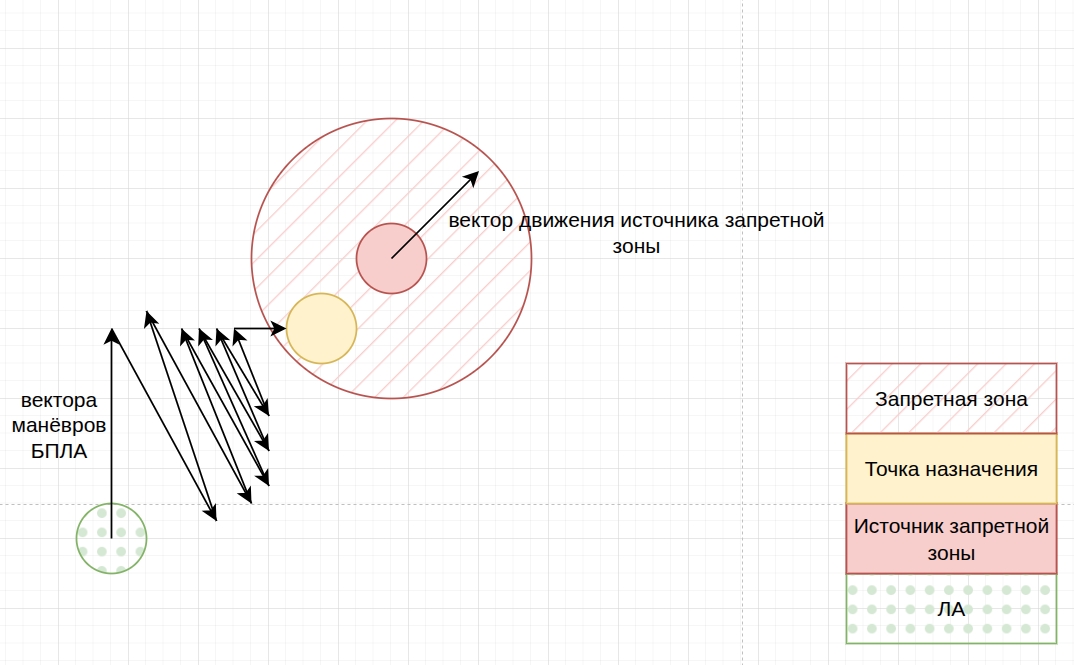
Рисунок 4 - Общая схема работы алгоритма семейства методов пространственного планирования
Глобальные планировщики (RRT*, PSO) оперируют всем пространством состояний, однако из-за высокой вычислительной сложности характеризуются крайне низкой частотой обновления, это также указывается в работе Чена и Вонга . В динамических средах, требующих генерации управляющих воздействий с частотой 10–50 Гц, архитектура данных методов принципиально не способна обеспечить полный пересчет графа или переоценку позиций роя частиц в реальном времени. При поглощении целевых координат движущейся запретной зоной алгоритмы сталкиваются с неразрешимым барьером: случайная выборка RRT* не может сгенерировать допустимые узлы в заблокированной области , а в методе PSO направленные к цели частицы получают бесконечные штрафы, что приводит к застреванию или смерти роя на границе препятствия. Попытка оптимизатора найти несуществующее глобальное решение провоцирует «вычислительный паралич» — критическую задержку расчета, при которой БПЛА продолжает движение по устаревшей траектории вплоть до аварийного прерывания миссии по тайм-ауту. Из-за отсутствия механизмов полноценного планирования включая временную данные методы воспринимают запретную зону в момент расчета как статичную и абсолютно непреодолимую преграду, полностью исключая возможность осознанного пространственного ожидания .
Сравнение алгоритмов DAA
Таблица 1 - Сравнение представленных алгоритмов DAA
Группа методов (Примеры) | Логика обхода запретной зоны | Итог при цели внутри зоны |
Потенциальные поля (APF) | Силы отталкивания | Дрожание, а потом зависание БПЛА |
Ограничения скоростей (VO, ORCA) | Проекция вне конуса коллизии | Сход с маршрута по касательной |
Таблич. Методы (ACAS Xu) | Максимизация награды | Резкий отворот и потеря цели |
Графовые (A*, D* Lite) | Дискретизация и поиск на сетке | Дрожание БПЛА вблизи границы запретной зоны |
Глобальные (RRT*, PSO) | Поиск по всему пространству | Зависание вычислений БПЛА |
Для наглядной демонстрации уязвимостей рассмотренных методов, в таблице 1 приведены результаты сравнительного анализа их реакций на нестандартный сценарий, при котором конечная цель маршрута находится внутри динамической запретной зоны.
Проведенный анализ выявляет фундаментальную проблему современных систем DAA: строго бинарное («здесь и сейчас») восприятие пространственных ограничений. В их математическом ядре отсутствует концепция ожидания изменения топологии среды. Ни одна из рассмотренных архитектур не способна выбрать осознанное удержание позиции перед движущейся зоной ради сохранения полетного задания. Данная уязвимость диктует необходимость разработки принципиально новых алгоритмов, удовлетворяющих следующим требованиям:
1 Механизм временной уступки: Алгоритм должен легитимизировать временную приостановку продвижения к цели. Системе необходима логика, позволяющая БПЛА осознанно уступить пространство динамической зоне (перейти в режим удержания позиции) с автоматическим возобновлением миссии после освобождения координат.
2 Математическое сглаживание воздействий: для исключения кинематического «дребезга» управление приоритетами должно быть непрерывным. Требуется внедрение математических функций-коммутаторов, обеспечивающих гладкое, но строгое перераспределение весовых коэффициентов между целью и препятствием.
3 Синтез целеполагания и реактивности: Система не должна отбрасывать глобальную миссию ради сиюминутного маневра уклонения, гарантируя при этом безусловное сохранение минимально допустимых интервалов безопасности в моменты сближения.
3. Заключение
В данной статье был проведен комплексный анализ поведения классических и современных алгоритмов обнаружения и предотвращения столкновений в условиях нестандартного краевого сценария, при котором конечный пункт назначения БПЛА оказывается временно поглощен динамической запретной зоной. Исследование показало, что существующие реактивные, графовые и вероятностные методы обладают фундаментальной уязвимостью, выраженной в неспособности разрешать конфликты целеполагания из-за строго бинарного восприятия пространства. Установлено, что применение традиционных подходов в таких условиях неизбежно приводит к зависанию аппарата в локальных минимумах, бесконечному уклонению с потерей маршрута или критическим вычислительным отказам систем планирования. Главной причиной выявленных сбоев является отсутствие в математическом ядре рассмотренных алгоритмов концепции пространственно-временного ожидания и механизмов осознанной временной уступки пространства. На основе выявленных ограничений обоснована острая необходимость разработки нового класса алгоритмов, базирующихся на гибком, непрерывном управлении приоритетами. В качестве перспективного решения сформулированы требования к внедрению математического аппарата нелинейной активации ограничений, что позволит БПЛА безопасно уступать дорогу надвигающейся угрозе и гарантированно завершать миссию после освобождения целевых координат точки назначения.