Диагностика состояний для адаптивного управления ошибками в распределенных системах
Диагностика состояний для адаптивного управления ошибками в распределенных системах

Аннотация
В статье представлены подходы к разработке инструментов мониторинга состояний сложной распределенной системы и управления ошибками, которые возникают в процессе ее функционирования. В предположении, что система представляет собой «черный ящик», для идентификации ошибок используются наблюдаемые значения показателей. Рассмотрены возможные типы требований к этим значениям и построены оценочные функции (d-оценки), которые позволяют оценить отклонение от нормы. Для идентификации состояния системы и составляющих ее объектов разработан комплекс лингвистических шкал, которые позволяют сформировать как количественные, так и качественные (лингвистические) оценки. Предложена типизация ошибок, возникающих в системе, и протоколы диагностики состояния объектов и системы в целом. Для управления ошибками разработана многоагентная система. Изложены принципы функционирования механизма назначения компенсирующих воздействий, который позволяет автоматизировать процесс разрешения инцидентов в системе. Предложен алгоритм адаптивного управления ошибками, основанный на корректировке рейтингов правил назначения компенсирующих воздействий.
1. Введение
Актуальной задачей для сложных систем с распределенной структурой является автоматизация процессов поддержания работоспособности системы. Под системой с распределенной структурой будем понимать совокупность большого числа компонентов, объединенных для достижения общей цели и обладающих высоким уровнем автономности и связности. Примерами таких систем могут служить системы с сервисной архитектурой (SOA), робототехнические системы и комплексы, то есть информационные и программно-аппаратные системы, обладающие такими свойствами, как распределенность, автономность компонентов, децентрализация, в которых глобальная цель достигается за счет кооперации и взаимосвязанности компонентов
, , .Под объектом Obj будем понимать структурную единицу системы (сервис, программный или программно-аппаратный модуль и т.д.), выполняющую определенную функцию, по сути, представляющую собой автономный функциональный элемент. Система состоит из множества объектов, которые находятся между собой в некоторых отношениях. Подмножества объектов могут образовывать подсистемы данной системы. Совокупность объектов и отношений между ними образует структуру системы.
В системах с распределенной структурой инструменты управления и мониторинга играют ключевую роль, обеспечивая контроль за состоянием и производительностью объектов, а также управление конфигурацией и обработку ошибок, выполняемую, как правило, командой разработчиков. Под ошибкой подразумевается внутреннее состояние системы, которое является отклонением от состояния, удовлетворяющего функциональным и нефункциональным спецификациям системы, тогда как сбой системы приводит к тому, что система перестает выполнять свои функции. Управление ошибками (error management) — это процесс выявления, анализа, исправления и предотвращения ошибок. В системах с распределенной структурой он включает принципы, инструменты и алгоритмы поддержания работоспособности, которые позволяют обрабатывать сбои в распределенных системах, состоящих из независимых объектов. Автоматизация этих процессов позволит значительно повысить эффективность и востребованность подобных систем. Примерами автоматизированных инструментов для мониторинга, визуализации, масштабирования и автоматического перезапуска компонентов в системах с сервисной архитектурой могут служить Prometheus, Grafana, Kubernetes
, , .Наряду с инструментальными решениями, в научной литературе активно развиваются теоретические подходы к управлению ошибками в распределенных системах. Существует ряд классификаций и обзоров, охватывающих методы отказоустойчивости, самоадаптации и активного управления отказами
, , . В работе представлена систематическая классификация подходов к обеспечению отказоустойчивости в распределенных и облачных средах, выделяющая реактивные, проактивные, адаптивные и гибридные стратегии; в систематизированы работы по проектированию самоадаптивных систем с использованием методов теории управления; в рассмотрены методы активного управления отказами в динамических системах.В реальных сложных распределенных системах построение релевантной аналитической модели требует полной и прозрачной структуры системы, что в условиях сложных распределенных сред зачастую принципиально недостижимо. Более того, многообразие классов ошибок и уникальность конфигураций делают любую предопределенную модель принципиально неполной. Известно, что даже базовые вероятностные модели
, сталкиваются с фундаментальными ограничениями применимости к реальным сложным системам, что служит прямым обоснованием необходимости перехода к предлагаемому адаптивному подходу, не требующему полного знания внутренней структуры объекта управления.Это формирует принципиальную предпосылку для подхода к управлению ошибками, основанного на косвенном адаптивном воздействии на основную систему, трактуемую как «черный ящик», что актуализирует решения, связанные с диагностикой объектов в условиях неопределенности.
В статье представлены результаты исследования, направленного на разработку информационной среды для моделирования многоагентной системы (МАС) адаптивного управления ошибками для распределенных информационных систем. В рамках данного исследования разработан формальный аппарат для оценки состояния объектов по наблюдаемым параметрам в условиях неопределенности (на основе концепции «черного ящика»), обеспечивающий унифицированную обработку разнородных данных и формализацию пороговых значений для выявления инцидента и критической ошибки.
Для достижения цели были решены следующие задачи:
– классифицированы типы требований к значениям показателей;
– построены оценочные функции для количественной оценки отклонений; разработаны лингвистические шкалы для интерпретации состояний;
– формализованы пороги инцидента и критической ошибки;
– предложена архитектура модели МАС, использующей эти формализации для адаптивного управления ошибками.
2. Диагностика состояния системы
Процесс функционирования системы сводится к процессам функционирования объектов в их взаимосвязи, при этом каждому объекту Obj присуще некоторое состояние Situ(Obj). Совокупность состояний объектов предопределяет состояние всей системы Situ(S). В процессе функционирования объекта (системы) можно выделить нормальное состояние, которое соответствует эталонной работоспособности, и состояния, вызванные различными нарушениями в работе или внешними факторами, которые обусловливают отклонения от нормального состояния. Введем универсальную лингвистическую переменную Situ = "Состояние" для формального описания состояний системы и составляющих ее объектов. Переменная принимает значение в шкале
С учетом введенных кратких обозначений определим универсальную лингвистическую шкалу в виде
В предположении, что каждый показатель является количественным, при идентификации ошибки, инициированной показателем, необходимо учитывать требование к его значению. Эти требования можно классифицировать следующим образом:
- требование первого типа — значение показателя не должно превосходить заданного значения
- требование второго типа — значение показателя должно превосходить заданное значение
- требование третьего типа — значение показателя не должно выходить за границы заданного диапазона
Зафиксируем объект
- для требования первого типа (норма
- для требования второго типа (норма
- для требования третьего типа (норма
Таким образом, для каждого показателя с помощью величины
На
1) для показателя с требованием первого типа носитель терма
2) для показателей с требованием второго типа носитель терма
3) для показателей с требованием третьего типа носитель терма
Определим, например, шкалу
За счет совмещения шкал количественная оценка степени нарушения требований получает качественную интерпретацию, принимая значение некоторого терма, которому соответствует максимум функции принадлежности.
Пусть, например, к показателю предъявляется требование первого типа и
Таким образом, для каждого показателя можно определить степень нарушения требования как в количественной, так и в лингвистической форме.
Заметим, что у каждого показателя имеется своя частная лингвистическая шкала. Переход к универсальной лингвистической шкале осуществляется за счет процедуры унификации
. В результате каждый терм частной лингвистической шкалы представляется нечетким подмножеством универсальной лингвистической шкалы.Пусть
Таким образом, базовую лингвистическую шкалу можно рассматривать как универсальный инструмент, позволяющий представить разнородную информацию унифицированным способом без потери качества исходной информации. Информация о состоянии объекта может быть представлена в числовой шкале в виде числа, в частной лингвистической шкале — в виде терма этой шкалы, а также в форме нечеткого подмножества термов универсальной лингвистической шкалы.
Предположим, что функционирование любого объекта Obj описывается набором показателей (параметров)
Под ошибкой, инициированной показателем, будем понимать нарушение требования к значению этого показателя.
Пусть
Под ошибкой, инициированной объектом, будем понимать нарушение работоспособности данного объекта, которое приводит к нарушению качества функционирования системы.
Ошибка, инициированная системой, возникает при нарушении работоспособности ее объектов в их взаимодействии.
Таким образом, с помощью полученной формализации состояний объекта можно конкретизировать понятия инцидента и критической ошибки.
Инцидент — это некритическая ошибка, соответствующая переходу статуса объекта в зону слабого отклонения. Его возникновение является сигналом для автоматического запуска механизма компенсации со стороны надстройки. Формально порог возникновения инцидента, hinc , может быть определен как точка пересечения функций принадлежности к «норме» и к «сильному отклонению».
Критическая ошибка возникает при переходе в зону существенного отклонения, порог hcr, что указывает на высокую вероятность скорого сбоя. Порог hcr может быть определен как точка пересечения функций принадлежности к «сильному отклонению» и к «существенному отклонению». Такая ситуация может требовать эскалации, уведомления команды разработчиков и, потенциально, остановки работы для глубокого анализа.
Значения функций принадлежности порога инцидента и критической ошибки позволяют определить интервал использования процесса адаптивного управления ошибками, на котором возможно разрешение инцидента:
Возможны ситуации, когда комбинация отклонений от нормального состояния приводит к нарушению работы объектов и системы в целом, что приводит к возникновению проблемы оценивания сложившейся ситуации в целом. Решением могут служить различные протоколы диагностики состояния объекта:
1. Выявление показателей, для которых нарушение требований является критичным и нарушает работу системы. Если в процессе мониторинга хотя бы для одного такого показателя возникнет существенное отклонение от нормы
2. Определение системы приоритетов на множестве показателей, когда каждому показателю приписывается вес, отражающий его значимость для объекта. Данный подход позволяет учитывать предыдущий случай, когда накопление отклонений для менее значимых показателей может привести к критической ошибке.
3. Если все показатели равноценны, то для описания возникающих ситуаций необходимо сформулировать принцип учета отклонений: если требование нарушается (хотя бы по одному показателю, или по всем показателям, или по большинству показателей, или по крайней мере по m из n показателям — конкретный вариант определяется системой), то возникает отклонение в функционировании объекта. Такое приближенное количество показателей называется лингвистическим квантором и формально задается функцией квантификации
.В первом случае необходимо диагностировать те показатели, которые являются критическими, и, если обнаружено отклонение от нормы, то применять компенсирующее воздействие. В остальных случаях для учета требований к значению показателей можно использовать процедуру агрегирования векторной оценки в скалярную величину
.Таким образом диагностика работоспособности объектов и распределенной системы в целом будет осуществляться по наблюдаемым параметрам, полагая основную систему «черным ящиком», но при этом фиксируя отклонения статусов объектов от нормы при помощи предложенных моделей.
3. Разработка многоагентной системы для адаптивного управления ошибками
Адаптивное управление ошибками представляет собой динамический самонастраиваемый процесс поддержания работоспособности сложных распределенных систем, основанный на автоматическом выборе и применении к объекту компенсирующих воздействий из библиотеки алгоритмов компенсации. Выбор инициируется при обнаружении отклонения текущего статуса объекта от эталонного значения. Ключевым механизмом процесса назначения компенсирующих воздействий является алгоритм эволюционной оптимизации назначенных им рейтингов, отражающих относительную прогностическую оценку вероятности успешного разрешения ошибки.
Адаптивное управление ошибками позволяет автоматизировать процесс разрешения инцидентов, возникающих в процессе работы сложных распределенных систем, используя модели и методы обработки приближенной информации, базирующиеся на принципах диагностики объектов, изложенных выше. Это обеспечивает универсальный подход к обработке разнородных данных о состоянии системы
, .В контексте решаемой задачи объект может быть представлен кортежем:
где att — векторная оценка объекта, отражающая его признаки, качества и свойства или их отсутствие;
st — векторная оценка объекта, отражающая его признаки, качества и свойства или их отсутствие;
st1 — векторная оценка объекта, отражающая статус его компонентов в исходном состоянии;
st2 — векторная оценка объекта, отражающая статус его компонентов в измененном состоянии.
Компенсирующее воздействие (КВ) в данном контексте представляет собой последовательность команд, направленных на поддержание работоспособности объекта, представленных в формате, совместимом с программным обеспечением объекта (точкой входа). Оно назначается при выявлении отклонений, доступных для мониторинга параметров компонентов объекта st1i, от эталонных значений sti при заданном промежутке допустимых значений падения статусов; результативность применения оценивается по полученным значениям измененного статуса st2i.
Модель многоагентной системы (МАС)
является универсальной надстройкой к распределенной информационной системе. В дальнейших рассуждениях такую систему будем называть основной (ОС) и рассматривать как «черный ящик». Входной информацией для МАС являются наблюдаемые параметры ОС, объекты являются точками входа для подключения МАС.Для формального описания архитектуры модели МАС введем ориентированный агентный граф
V — множество вершин, соответствующих функциональным компонентам МАС;
Вершины графа AG идентифицируются следующим образом:
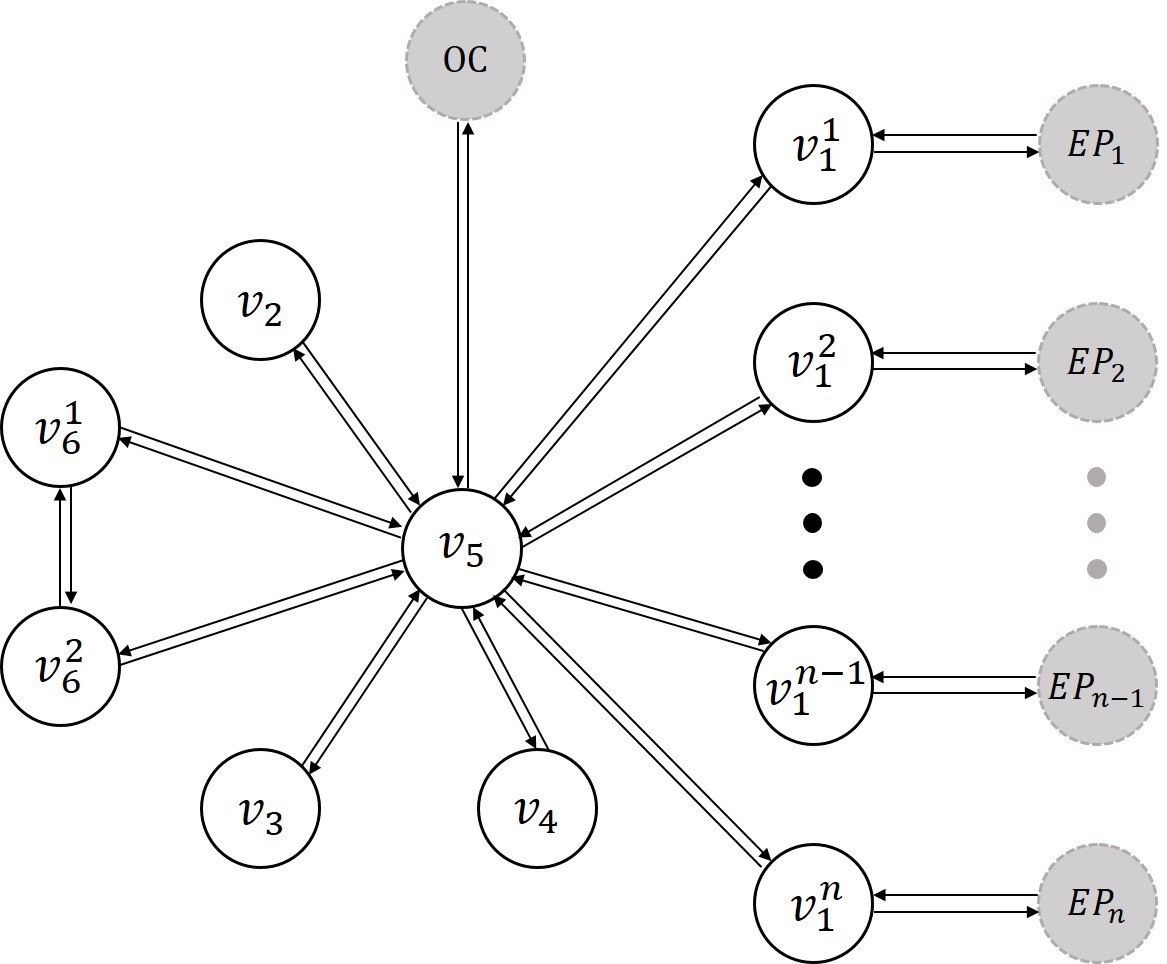
Рисунок 1 - Агентный граф AG
- получение статусов показателей текущего состояния объекта;
- масштабирование;
- выявление инцидентов и их разрешение;
- мониторинг и уведомление об инцидентах и критических ошибках.
Выявление инцидента происходит в соответствии с принципами диагностики объектов, рассмотренными выше. Разрешение инцидентов и поддержание работоспособности ОС происходит за счет работы с компенсирующими воздействиями, обеспечивающейся алгоритмом адаптивного управления ошибками в распределенных информационных системах, представленном на рис. 2.
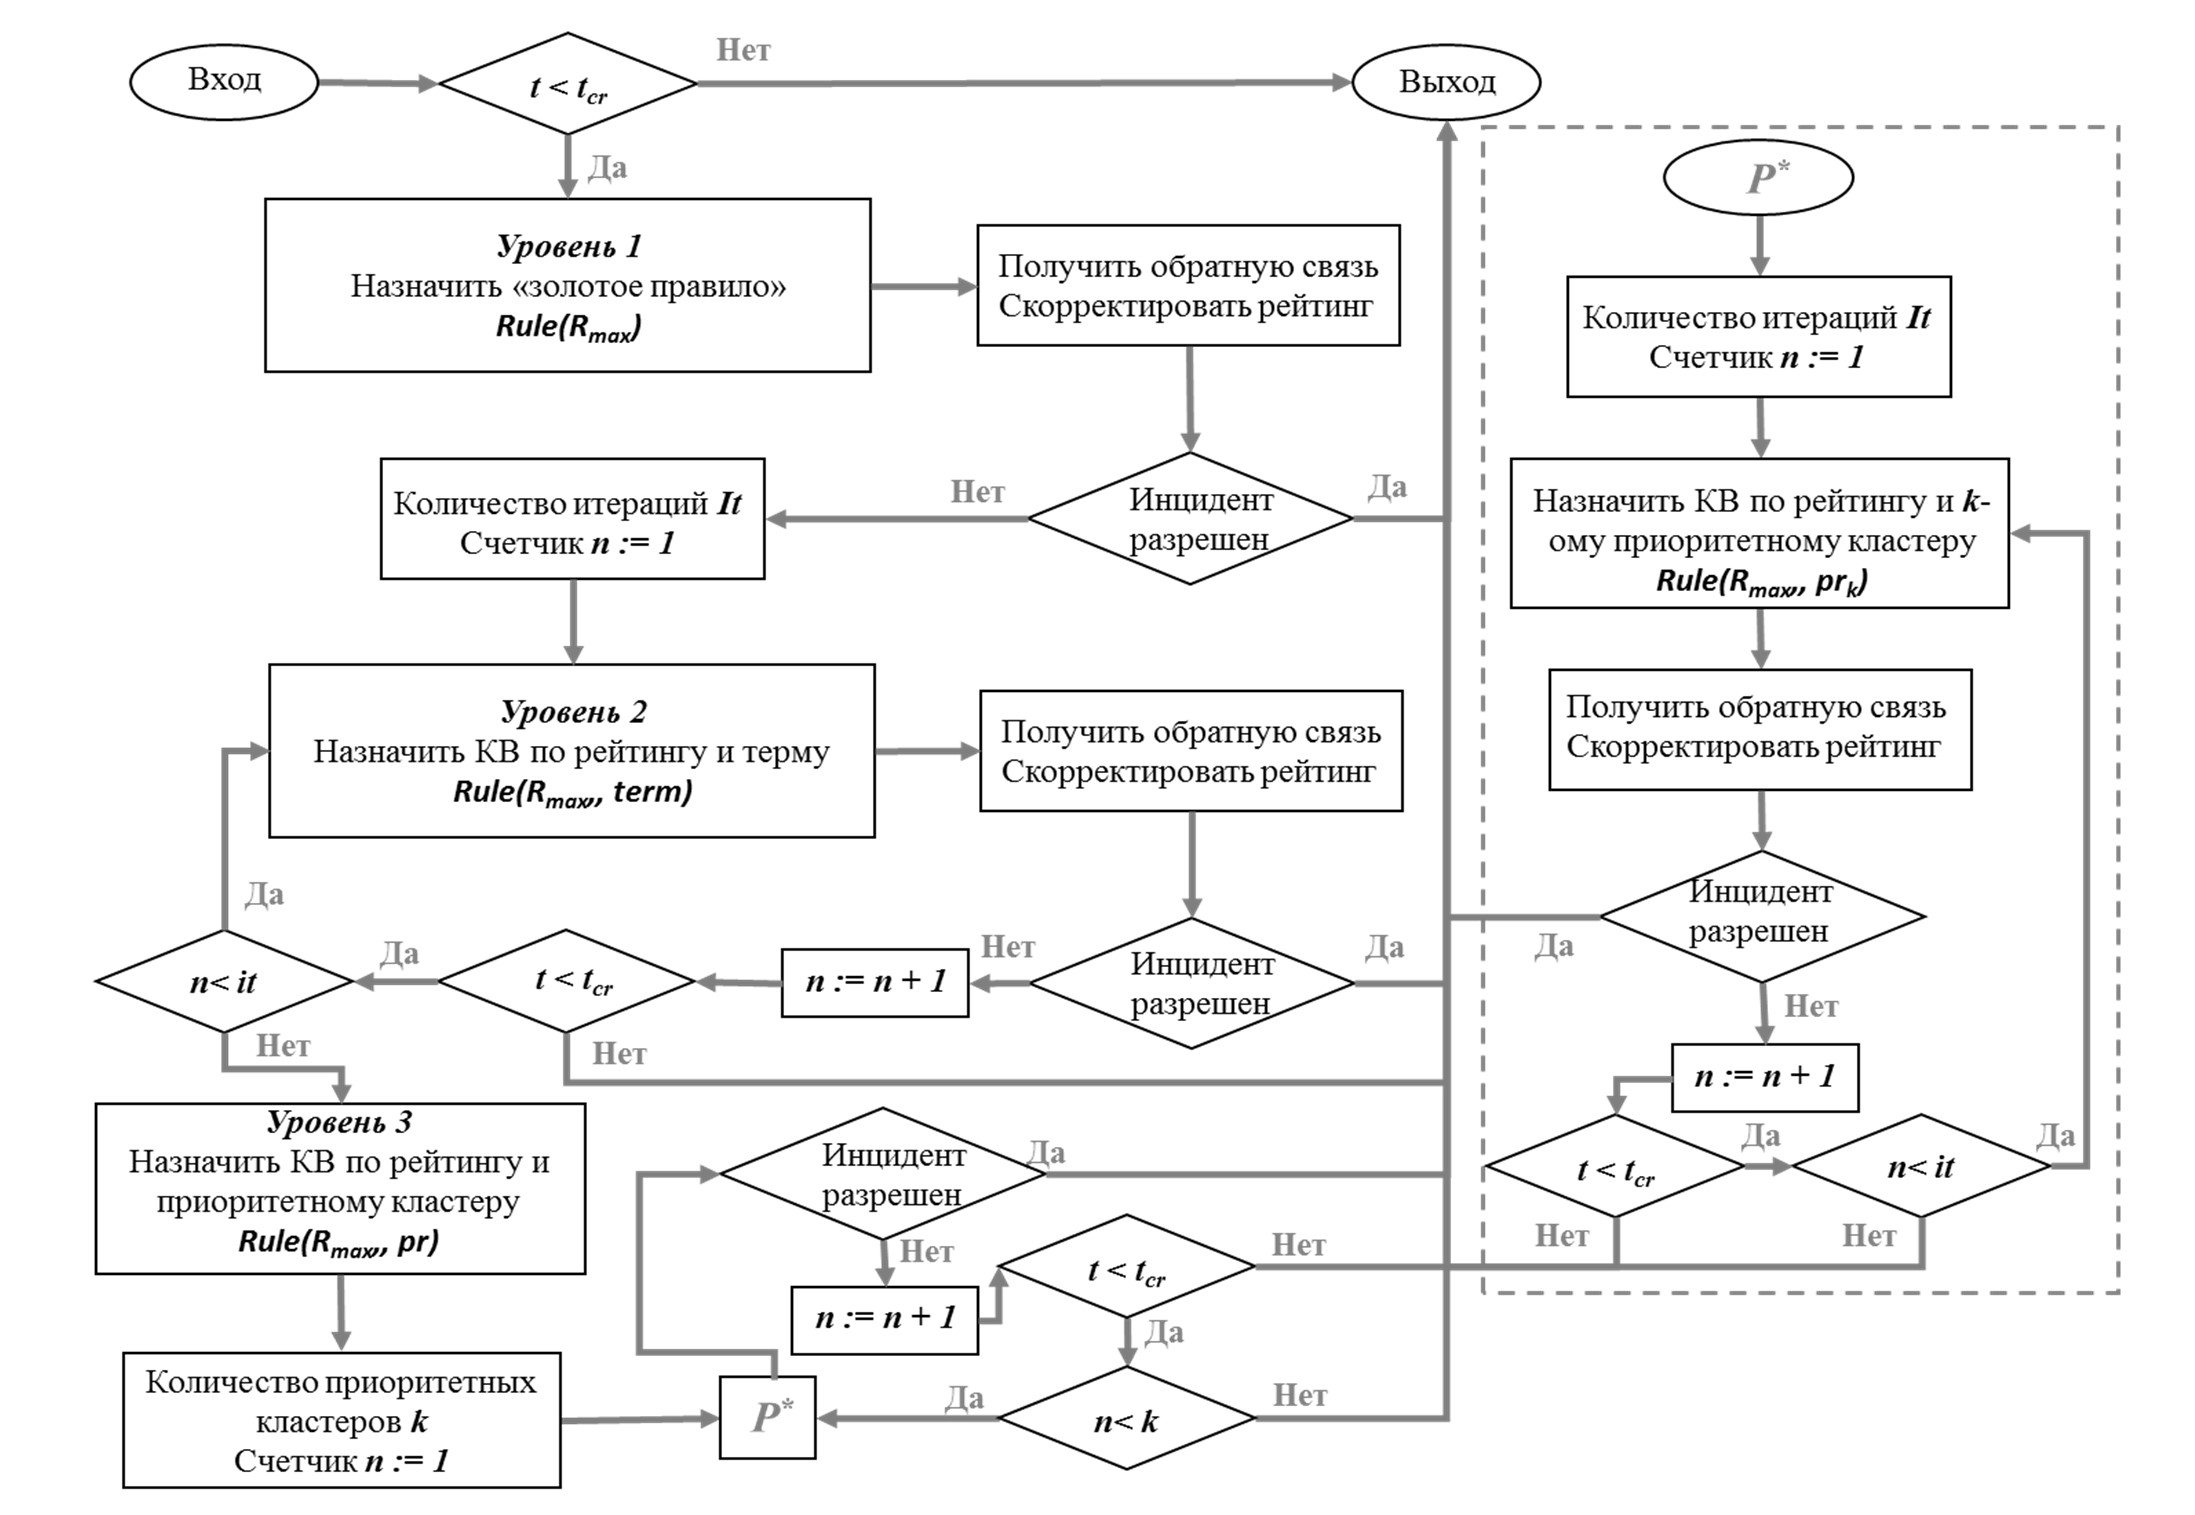
Рисунок 2 - Блок-схема алгоритма работы с компенсирующими воздействиями
Величина коррекции рейтинга зависит от значения изменений показателей текущего статуса объекта, что также повышает оценку эффективности назначения КВ.
Для оценки текущего статуса объекта вводится лингвистическая переменная
на универсальном множестве
Функция принадлежности для каждого терма соответствует треугольному нечеткому числу (a, l, r)
и, как показано ниже, определяется следующим образом:Каждому компенсирующему воздействию присуще не менее одного значения терма, по которым осуществляется выбор назначаемого КВ в соответствии со значением текущего статуса объекта и выбранной стратегией. Для конъюнктивной стратегии выбирается самое низкое из возможных значений терма, для дизъюнктивной — самое высокое, компромиссная стратегия подразумевает выбор промежуточного значения терма или его рандомное назначение. На рис. 3 представлен пример определения термов для текущего показателя статуса объекта.
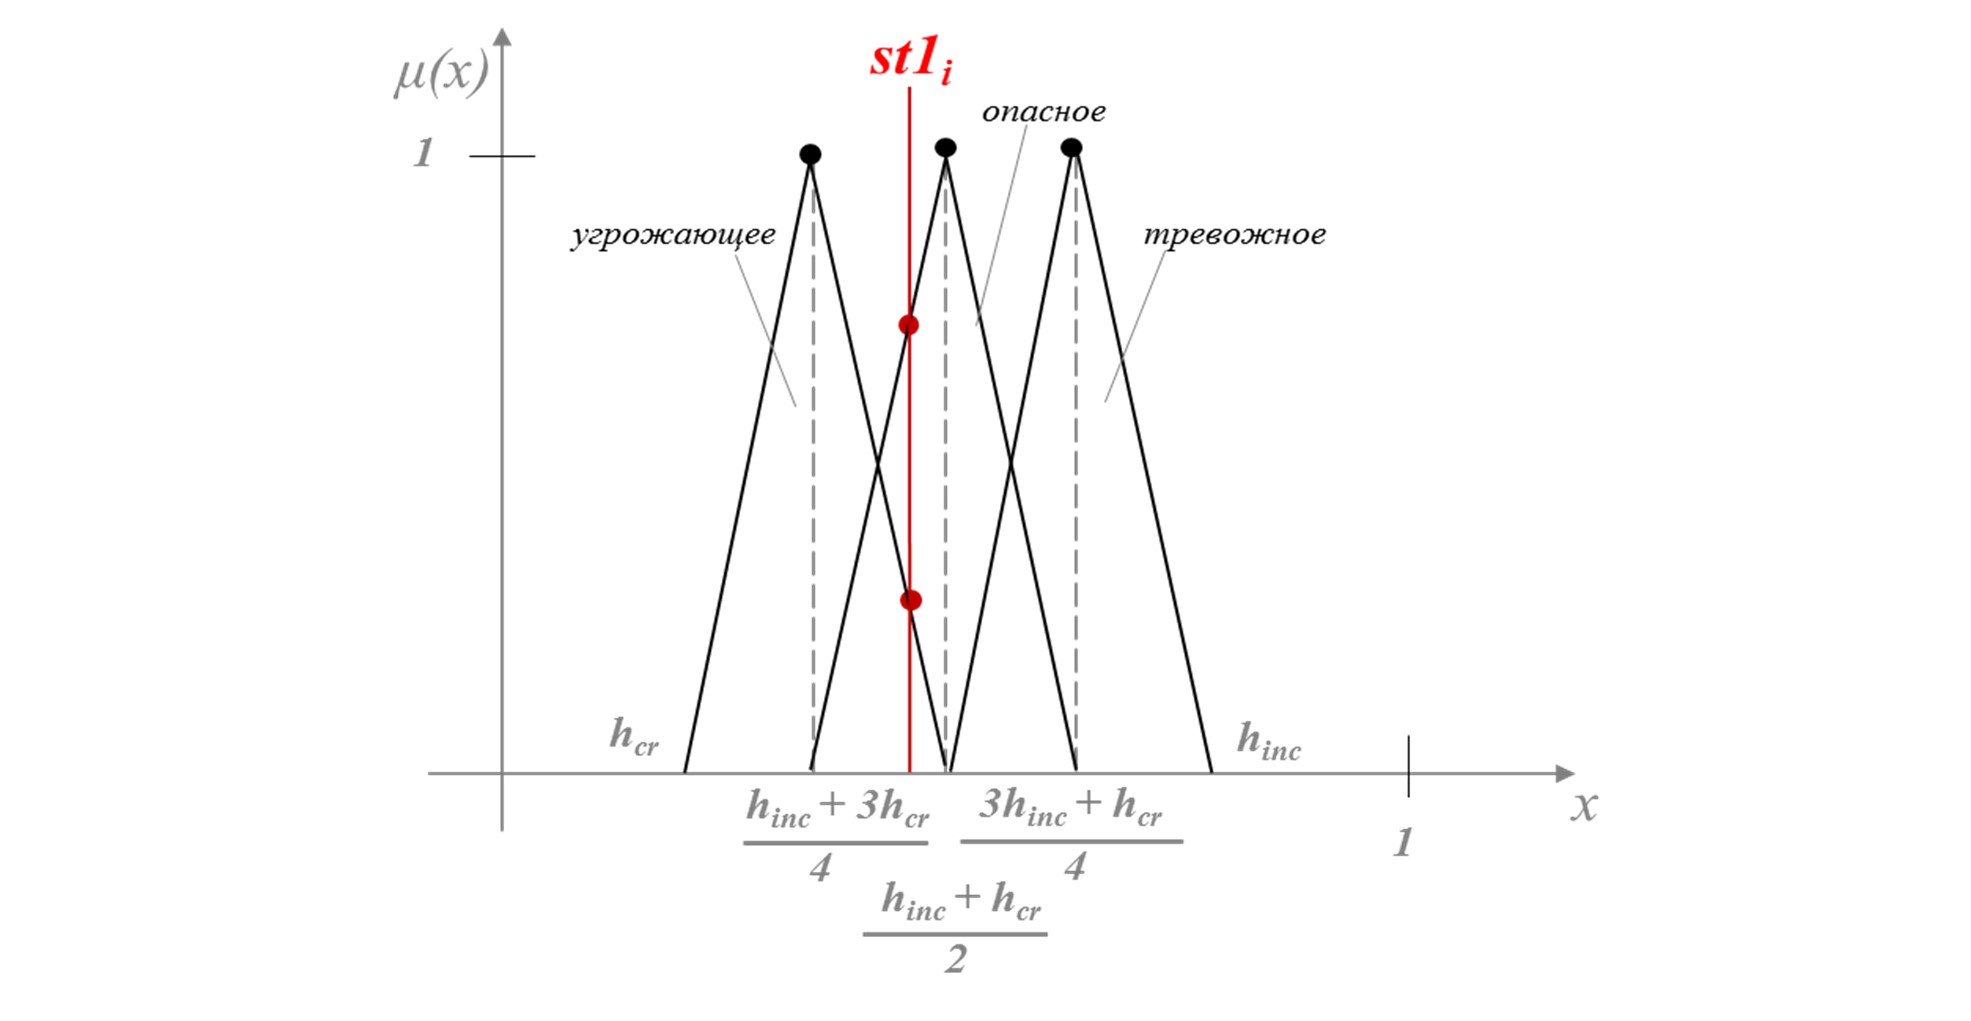
Рисунок 3 - Пример определения термов для текущего показателя
Одинаковые кластеры присущи КВ, ориентированным на решение схожих проблем, обусловленных определенным набором атрибутов объекта. Такие правила являются наименее универсальными, но при этом они могут стать наиболее точным инструментом для разрешения инцидента в соответствии с атрибутами объекта.
При получении значения текущего статуса объекта, удовлетворяющего условию
Авторами разработана программная реализация предложенного в статье алгоритма работы с компенсирующим воздействиями «Универсальный модуль назначения компенсационных воздействий для адаптивного управления ошибками в распределенных информационных системах», позволяющая эмулировать различные сценарии для проведения экспериментального исследования. В ходе эксперимента была исследована динамика адаптации модели. Для этого на эмуляторе было обработано 100 инцидентов по сценарию, предусматривающему изменение условий — введение новых объектов после обработки сорока инцидентов, визуализация результата эксперимента представлена на рис. 4.
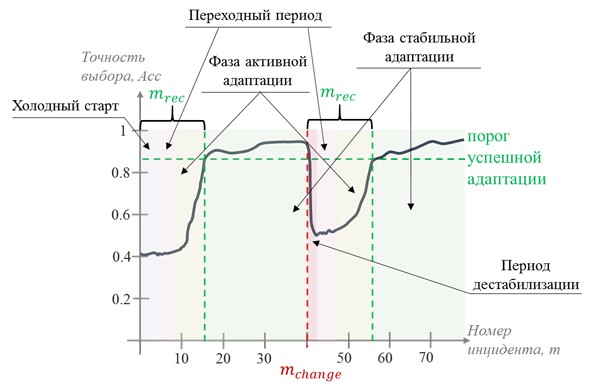
Рисунок 4 - Динамика адаптации модели при изменении условий
4. Заключение
Адаптивная система управления ошибками позволяет решить задачу автоматизации поддержания работоспособности сложных систем, обладающих распределенной структурой. Использование представленных в статье подходов к оценке состояния объектов и всей системы в целом позволяет использовать как количественную информацию, так и качественную, выраженную лингвистическими термами для диагностики инцидента или критической ошибки. Хранилище данных системы обладает свойством самоорганизации и адаптивности. Работа хранилища данных имеет заданные временные ограничения, что повышает значимость вычислительной мощности и быстродействия системы. Решить эту проблему можно за счет использования многоагентных технологий , , , что обеспечит декомпозицию задач распределение мощностей и увеличение быстродействия системы за счет логистики взаимодействия агентов и возможности распределенного решения задач.
Получены следующие результаты исследования, обладающие научной новизной:
- формализованы
- построены частные и универсальная лингвистические шкалы, отличающиеся возможностью преобразования разнородных данных в единый формат и позволяющие интерпретировать состояния объекта как в количественной, так и в качественной форме;
- определены формальные пороги инцидента
- предложены протоколы агрегирования отклонений, отличающиеся гибкостью выбора стратегии учета показателей и позволяющие учитывать как приоритеты, так и равнозначность показателей при диагностике объекта;
- разработана архитектура модели МАС, отличающаяся адаптивностью и универсальностью и позволяющая поддерживать работоспособность распределенных информационных систем без доступа к их внутренней логике.
Предложенный в статье формальный аппарат для оценки состояния объектов по наблюдаемым параметрам (в условиях неопределенности, на основе концепции «черного ящика») использован для построения архитектуры модели МАС, использующей эти формализации для адаптивного назначения компенсирующего воздействия для разрешения инцидентов. Проведен вычислительный эксперимент, показавший точность доли верных выборов КВ ~ 85% при минимальных интеграционных затратах, что подтверждает эффективность рассматриваемого в статье подхода.