Использование механизма внимания в графовых нейронных сетях для фильтрации обучающих данных на примере рекомендательных систем
Использование механизма внимания в графовых нейронных сетях для фильтрации обучающих данных на примере рекомендательных систем

Аннотация
Современные рекомендательные системы демонстрируют высокую точность, но характеризуются значительной ресурсоемкостью, что затрудняет их практическое внедрение и масштабирование. Статья посвящена методу оптимизации обучения рекомендательных систем путем сокращения объема обучающих данных с помощью механизма внимания в графовых нейронных сетях. Предложенный подход, основанный на фильтрации менее значимых взаимодействий на основе весов внимания, позволяет снизить вычислительные затраты и ускорить процесс обучения без существенной потери качества рекомендаций. Экспериментальная проверка на датасете Amazon Books подтвердила эффективность метода для различных архитектур (LightGCN, BPR, KNN). Результаты работы указывают на перспективность использования механизмов внимания как средства повышения эффективности обучения.
1. Введение
Рекомендательные системы стали неотъемлемой частью современных цифровых платформ, обеспечивая персонализированный доступ к информации, товарам и сервисам. Они используются в интернет-магазинах для формирования индивидуальных товарных подборок, в медиасервисах — для ранжирования фильмов, музыки и новостей, в социальных сетях — для рекомендации друзей и так далее. Эффективность таких систем напрямую влияет на удовлетворенность пользователей, время взаимодействия с платформой и коммерческие метрики, что делает область рекомендательных алгоритмов одной из наиболее интенсивно развивающихся в современном машинном обучении.
1.1. Современные подходы и механизм внимания
В последние годы активно развиваются алгоритмы использующие глубокие нейронные сети, в частности нейронные сети, включающие механизм внимания. К наиболее заметным подходам относятся нейро-факторизационные модели, архитектуры последовательных рекомендаций на основе Transformer, вдохновленные достижениями в области языковых моделей, а также графовые модели , , , , .
1.2. Проблемы использования современных моделей машинного обучения
Современные рекомендательные модели демонстрируют впечатляющие результаты, однако их повсеместное внедрение часто оказывается существенно затруднено. Основная проблема заключается в высокой ресурсоемкости таких моделей, обусловленной несколькими факторами.
Во-первых, большинство актуальных архитектур — многослойные архитектуры, реализующие свое преимущество через масштабируемость за счет увеличения числа параметров.
Во-вторых, реальные рекомендательные системы работают в динамических условиях. Быстро появляются как новые алгоритмы, так и новые области, в которых необходимы точные рекомендации. Это приводит к необходимости частого обучения моделей. Для тяжелых моделей такая частота обновлений становится практически невыполнимой.
В-третьих, часто модели чувствительны к гиперпараметрам. Настройка и оценка требует полного цикла обучения, что в совокупности с ресурсоемкостью данного процесса приводит к невозможности полноценного анализа влияния параметров и в следствии использования эмпирических значений.
Таким образом, несмотря на высокую точность, современные рекомендательные модели оказываются трудными для использования в реальных системах из-за высокой вычислительной стоимости и требования к регулярному переобучению. Это формирует запрос на методы, которые позволяют ускорить обучение, уменьшить объем данных или снизить сложность модели без существенной потери качества.
2. Методы и принципы исследования
Ключевая идея настоящей работы концептуально опирается на подходы дистилляции знаний, активно развиваемые в области больших языковых моделей (LLM) , . В классической дистилляции знаний информация передаётся от сложной модели-учителя к более простой модели-ученику за счет использования внутренних состояний модели-учителя (обычно внутренних активаций). Однако в предлагаемом исследовании используется альтернативное направление дистилляции. Вместо внутренних состояний слоев нейросети источником знаний выступают веса внимания, формируемые крупной рекомендательной моделью. Значения внимания интерпретируются как индикатор важности отдельных взаимодействий пользователя с объектами. Это позволяет выделить наиболее информативные элементы обучающих данных и использовать их. Таким образом, предлагаемая работа переносит идеологию дистилляции из LLM в область рекомендательных систем, но делает это через механизм фильтрации данных, а не через передачу внутренних скрытых представлений.
2.1. Методы
Механизм внимания (attention) реализует предложение о том, что необходимо фокусироваться на наиболее значимых элементах входных данных. В рекомендательных системах это означает способность выявлять наиболее информативные пользовательские взаимодействия — такие, которые вносят наибольший вклад в итоговые рекомендации.
Интуитивно внимание работает как механизм адаптивного взвешивания: алгоритм самостоятельно определяет важные элементы, присваивая им большие коэффициенты значимости.
Формально механизм внимания для рекомендательных систем можно ввести следующим образом. Пусть пользователь
Тогда вес внимания для одного взаимодействия
В подавляющем большинстве методов машинного обучения адаптация модели происходит за счет минимизации функции потерь. В общем виде ее можно представить следующим образом
где
Заметим, что функция потерь, а следовательно, и оптимизируемое значение напрямую зависят от обучающей выборки, используемой для оптимизации параметров
Из этих предпосылок и формируется идея данной статьи – преобразовать функцию потерь в более компактный вид с минимальной потерей показателей использующих ее моделей. Как следствие такой подход должен ускорить как процесс настройки параметров моделей за счет более быстрого процесса обучения, так и процесс внедрения новых моделей за счет возможности использовать оптимизированные наборы данных с произвольными алгоритмами машинного обучения.
В графовых нейронных сетях (архитектурах на основе GAT , ) рекомендации строятся за счет формирования в процессе обучения латентных (скрытых) представлений вершин и пользователей. Релевантность рекомендации определяет близость полученных представлений, т.е. величиной скалярного произведения
где
В качестве графа рассматривается граф взаимодействий — двудольный граф
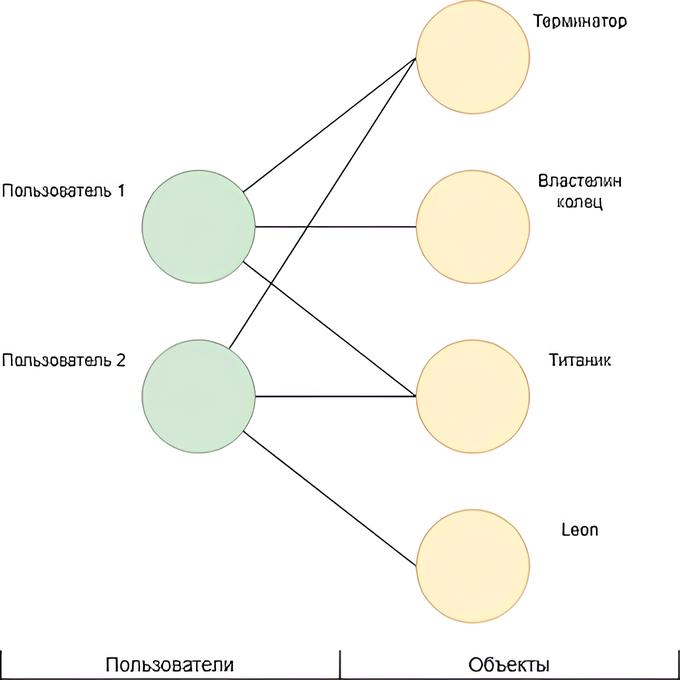
Граф взаимодействий
где
Оценка внимания вводится следующим образом:
где
Подставляя
Подбор обучаемых параметров
где
По окончании процесса оптимизации функции потерь значения
2.2. Материалы
Amazon Books представляет собой поднабор крупномасштабного корпуса пользовательских отзывов Amazon и содержит данные о взаимодействиях пользователей с товарами категории «книги».
В рамках задачи рекомендаций данные интерпретируются в постановке неявной обратной связи (implicit feedback), где наличие взаимодействия между пользователем и книгой рассматривается как положительный сигнал, а отсутствие взаимодействия — как неявный негативный сигнал.
Разделение на обучающую и тестовую выборку в обоих случаях производилось с использованием стратегии randomsplit, т.е. в качестве тестового набора используется случайная часть фиксированного размера. Размер тестовой выборки 20%.
2.3. Фильтрация
В связи с разреженностью данных могут существовать различия в результатах в зависимости от того, как будут отбираться взаимодействия по весам внимания:
- число k — выбирается фиксированное число взаимодействий на каждого пользователя, независимо от длинны истории, т.е. каждый пользователь ограничивается абсолютным значением;
- доля p — выбирается доля от общего числа, т.е. каждый пользователь ограничивается относительно длинны своей истории взаимодействий.
Результаты моделей сравниваются при каждом различном количестве взаимодействий на пользователя, в одном из трёх сценариев:
- random — для каждого пользователя выбирается k случайных или p процентов взаимодействий;
- top — для каждого пользователя выбирается k или p процентов взаимодействий с наибольшими весами внимания;
- bottom — для каждого пользователя выбирается k или p процентов взаимодействий с наименьшими весами внимания.
При этом полная модель GAT обучается на всем наборе и не участвует в оценке результатов после фильтрации. Параметры модели подбираются также по модели, использующей полный набор данных.
Максимальное значение k — 95 перцентиль длинны истории пользовательских взаимодействий. Для Amazon Books это примерно 100.
3. Основные результаты
Результаты предлагаемого подхода оценивается в паре с тремя различными вариантами алгоритмов коллаборативной фильтрации LightGCN, BPR и базового алгоритма ближайших соседей item-based KNN.
LightGCN — графовая нейронная сеть основанная на тех же принципах, что и GAT, но использующая механизм обновления весов без обучаемых параметров
где
Модель BPR напрямую оптимизирует представления пользователей и объектов путем минимизации ошибки в виде (8).
Item-based KNN использует для рекомендаций близость объектов в user-item матрице по корреляционному коэффициенту Пирсона.
Для оценки эффективности были использованы две метрики: Hit Ratio и Mean Reciprocal Rank или же HR@K и MRR .
Hit ratio — показывает долю предсказаний по которым в верхних
где
Mean Reciprocal Rank измеряет среднее значение обратного ранга первого релевантного объекта в рекомендованном списке, отражая способность модели помещать релевантный элемент на максимально высокую позицию.
Таким образом, HR@30 оценивает вероятность появления правильной рекомендации в выдаче из 30 объектов, а MRR — близость результата к началу выдачи.
Эксперименты над Amazon Books показывают следующие результаты (рисунки 2 и 3):
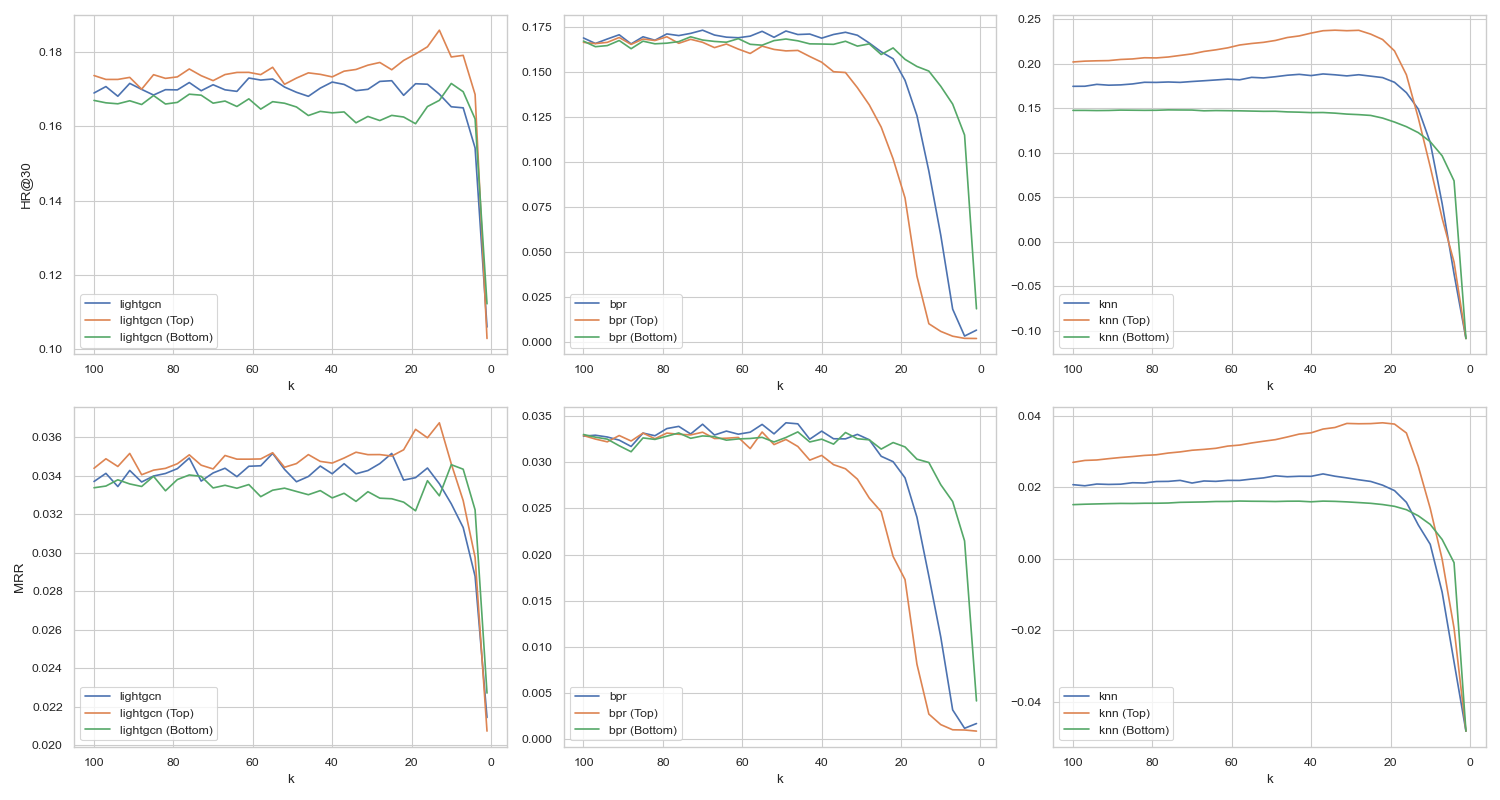
Рисунок 2 - Результаты для k
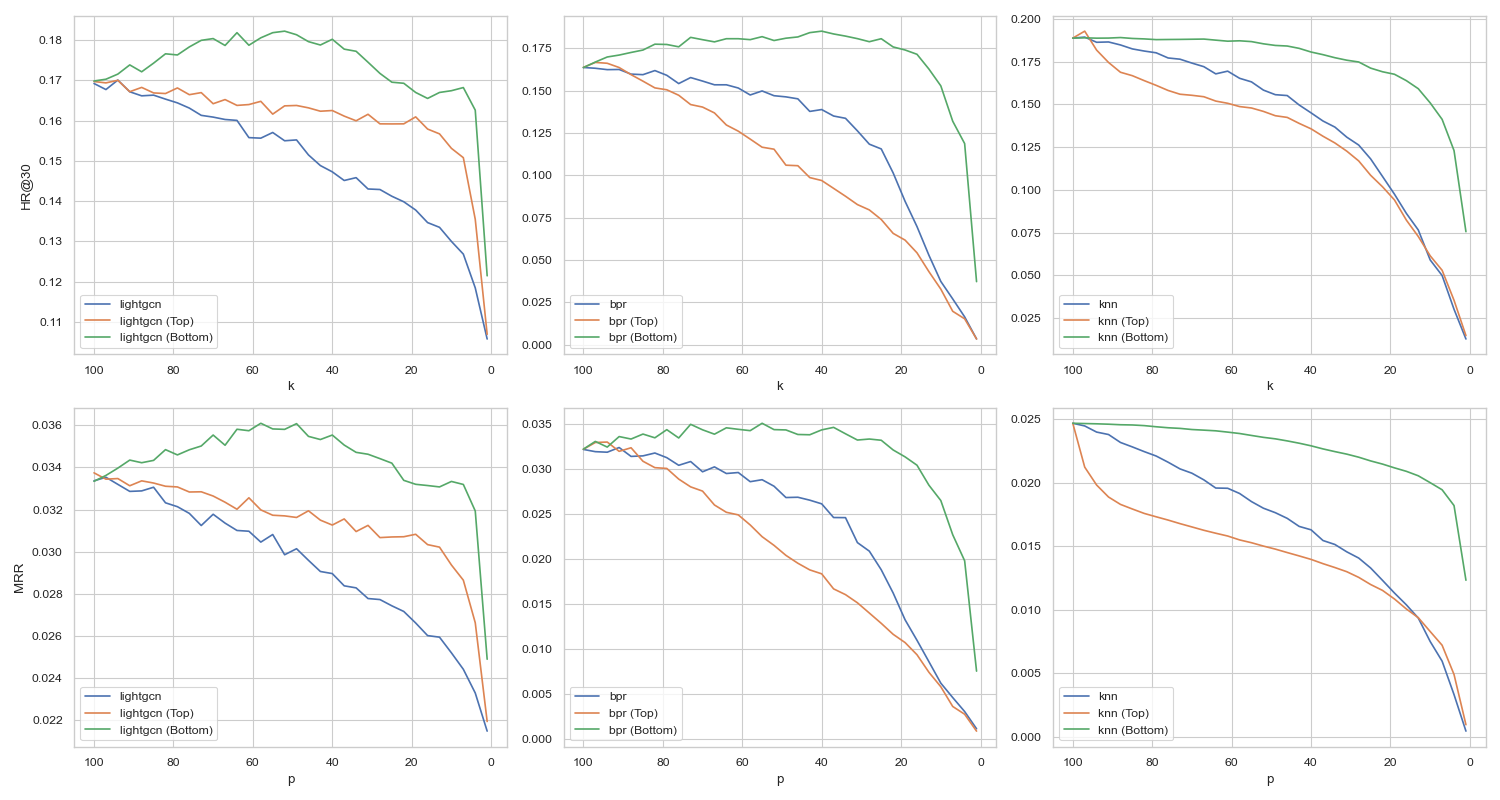
Рисунок 3 - Результаты для p
4. Обсуждение
Как может быть видно из графиков, результат разнится в зависимости от применяемой модели. При этом непосредственно в рамках одной модели наблюдаемые метрики демонстрируют одинаковую динамику.
Также стоит заметить, что для всех экспериментов свойственно падение метрик к 0 взаимодействий на пользователя. Это говорит как об адекватности моделей (отсутствие пользовательской истории приводит модели к случайным предсказаниям), так и о наличии некоторого оптимального значения длинны пользовательской истории.
Для вариации с k наиболее значимый вывод — результаты с фильтрацией по значению внимания почти полностью совпадают со случайной выборкой. Второй вывод — для отдельных моделей фильтрация позволяет сместить точку падения метрик, но в зависимости от самой модели лучшие результаты показывает фильтрация по максимальному вниманию (KNN), минимальному значению (BPR) или же вовсе не оказывают существенного влияния (LightGCN).
Интереснее выглядит вариация с p. Для всех трех моделей фильтрация показывает возможность снизить объем обучающих данных. При этом для LightGCN и BPR дополнительно наблюдается прирост метрик.
Недостатком же служит тот факт, что различные модели выдают различную динамику изменения метрик, что не дает универсальных рекомендаций к применению представленного подхода и требует проведения разведывательного анализа, что может в ряде сценариев свести к минимуму полезность применения представленного метода.
5. Заключение
В настоящей работе был исследован подход к сокращению объема обучающих данных рекомендательных систем на основе использования механизма внимания графовых нейронных сетей.
Проведенные эксперименты показали, что переиспользование оценок внимания модели GAT позволяет для представленных моделей сохранять качество при повышении скорости обучения.
Полученные результаты подтверждают перспективность использования механизмов внимания как инструмента оптимизации обучающих данных, особенно в условиях, в которых модели с механизмом внимания уже интегрированы в рекомендательные системы. Предложенный подход открывает возможности для снижения вычислительных затрат при обучении рекомендательных систем, ускорения подбора гиперпараметров и более эффективного применения ресурсоемких моделей в условиях регулярного обновления данных.
Развитием идеи, представленной в данной статье может послужить исследование других моделей с использованием внимания, например, вариантов генеративных и последовательных моделей.