Исследование рекомендательных систем для создания оптимального ансамбля и получения релевантных результатов
Исследование рекомендательных систем для создания оптимального ансамбля и получения релевантных результатов

Аннотация
В статье проведено исследование рекомендательных систем и их метрик с целью определения кандидатов для построения ансамблевых решений, повышающих релевантность рекомендаций. Актуальность обусловлена ограничениями классических подходов (проблема холодного старта, разрежённость матрицы оценок, «пузырь фильтрации») и возрастающей сложностью пользовательских предпочтений. Экспериментальной базой для вычислений является датасет MovieLens 25M, на основе которого была подготовлена стратифицированная подвыборка, где данные были разбиты темпорально на обучающую, валидационную и тестовую выборку. Реализовано 13 методов, охватывающих основные классы алгоритмов — неперсонализированные базовые методы, методы матричной факторизации, коллаборативная фильтрация на основе ближайших соседей, нейросетевые методы, контентные и гибридные подходы. Оценка была выполнена по 9 метрикам, отражающим точность предсказания рейтингов (RMSE, MAE), качество ранжирования (NDCG, MRR, Precision, Recall), а также системные характеристики (Coverage, Diversity, Inference). Установлено, что ни один метод не превосходит остальные по всему набору характеристик. На основе выявленных комплементарных свойств предложены две ансамблевые конфигурации: NCF + FunkSVD (акцент на точность) и NCF + HybridSVD Emb (баланс точности и охвата каталога). Результаты подтверждают перспективность гибридных ансамблей для преодоления ограничений отдельных методов.
1. Введение
В настоящее время поиск релевантного контента в информационно-перегруженном пространстве требует значительных временных затрат и не гарантирует оптимального результата. Рекомендательные системы, автоматически формирующие персонализированные подборки на основе истории взаимодействий пользователей, решают эту задачу только частично, так как классические методы (коллаборативная фильтрация и контентно-ориентированные методы
) имеют принципиальные ограничения . Среди основных недостатков можно выделить проблему холодного старта и разреженность матрицы оценок для коллаборативной фильтрации, а также ограниченность признакового пространства и склонность к «пузырю фильтрации» для контентных методов .Гибридные подходы позволяют во многом устранить эти недостатки
, однако вопрос о том, какие именно рекомендательные системы лучше объединить в ансамбль для обеспечения наибольшего прироста качества и точности рекомендаций остаётся недостаточно изученным . К тому же рост масштабов платформ и усложнение пользовательских предпочтений делают задачу повышения релевантности результатов работы рекомендательных систем всё более актуальной и практически значимой.Целью работы является исследование стандартных рекомендательных систем и их метрик для определения наилучших компонентов ансамбля, позволяющего получать релевантные результаты, с использованием методов машинного обучения.
Ключевой особенностью проведенного исследования является создание единого экспериментального пайплайна, реализующего 13 методов рекомендаций, оцениваемых по 9 метрикам каждый, и воспроизводимое разбиение данных на основе датасета MovieLens 25M, что обеспечивает объективность сравнения и новизну исследования.
2. Методы и принципы исследования
В качестве экспериментальной базы используется датасет MovieLens 25M
, содержащий анонимизированные оценки фильмов, собранные на платформе MovieLens. Полный датасет включает 25 000 095 оценок, выставленных 162 541 пользователем для 62 423 фильмов. Оценки проставляются по шкале от 0.5 до 5.0 с шагом 0.5, что соответствует задаче предсказания явных рейтингов (explicit feedback). Данный датасет, включающий метаданные фильмов (название, год выпуска, жанры), пользовательские теги и оценки, позволяет исследовать рекомендательные системы различных классов и сравнивать их между собой. При этом за счет наличия временной метки в формате Unix timestamp, прилагаемой к каждой оценке, возможно выполнить темпоральное разбиение данных — когда данные делятся не случайным образом, а в хронологическом порядке: старые взаимодействия идут в обучающую выборку, более свежие — в валидационную и тестовую (в пропорции 70% / 10% / 20%). Это максимально близко к реальной ситуации: система учится на истории и предсказывает то, что случится дальше.Для обеспечения вычислительной воспроизводимости экспериментов и возможности многократного переобучения сравнительный эксперимент проводился на тестовой выборке: 190696 оценок от 6348 уникальных пользователей, чьи взаимодействия хронологически следуют за обучающей и валидационной выборками.
В работе реализовано тринадцать методов, покрывающих все основные классы рекомендательных алгоритмов (представлены на рис. 1) — от неперсонализированных baseline-методов, которые задают нижнюю границу качества, до нейросетевого NCF.
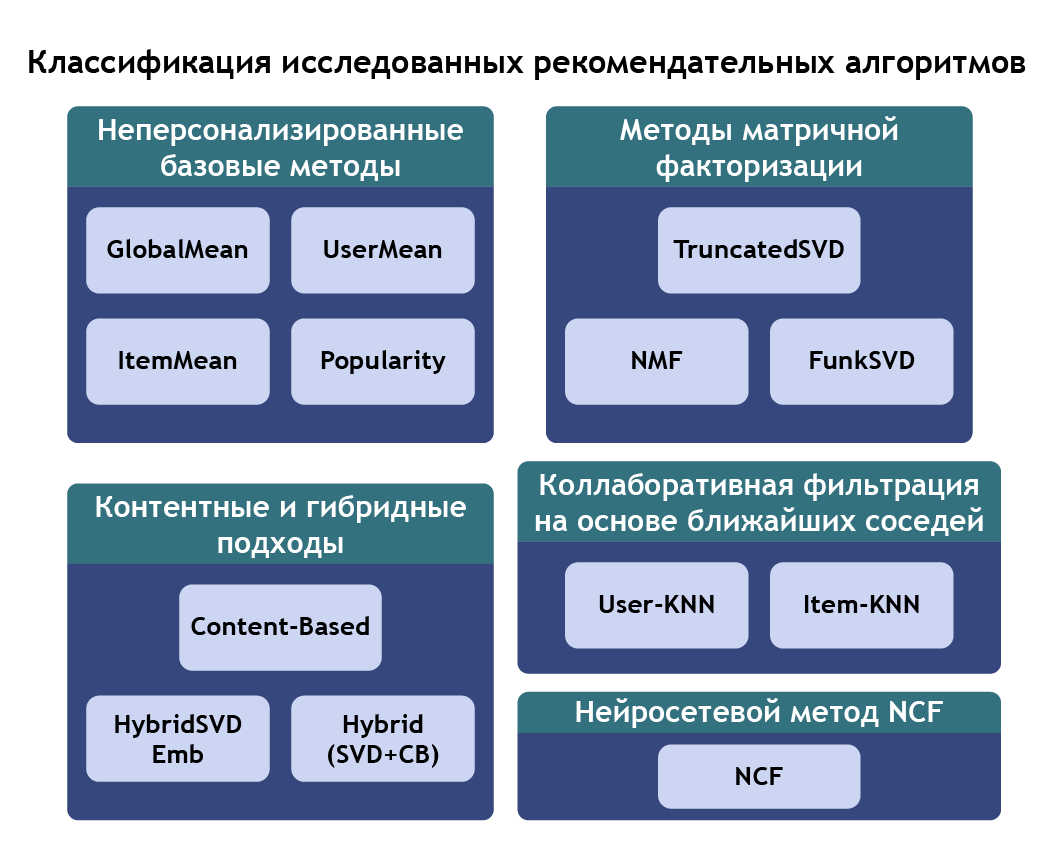
Рисунок 1 - Классификация исследованных рекомендательных алгоритмов
Для сравнения всех методов при проведении эксперимента использовались метрики трёх уровней: точность предсказания рейтинга — RMSE и MAE, качество ранжирования — NDCG, MRR, Precision и Recall, а также системные характеристики — покрытие каталога, разнообразие и время инференса
:
1) RMSE — среднеквадратичная ошибка;
2) MAE — средняя абсолютная ошибка;
3) NDCG — оценивает качество ранжирования с учетом порядка элементов;
4) Precision — точность (доля релевантных объектов среди всех предложенных);
5) Recall — полнота (доля найденных моделью релевантных объектов среди всех существующих релевантных);
6) MRR — средний обратный ранг первого релевантного объекта в списке;
7) Coverage — покрытие (доля каталога фильмов, попавшая в рекомендации хотя бы одному пользователю);
8) Diversity — разнообразие (степень различия между рекомендуемыми объектами);
9) Inference — время инференса, за которое модель выдает готовое предсказание.
При стремлении значений ошибок RMSE и MAE к нулю, точность результатов рекомендаций улучшается. Метрики NDCG, Precision, Recall, MRR и Coverage при стремлении к единице гарантируют качество релевантности результатов.
Такой многокритериальный подход необходим, поскольку ни одна отдельная метрика не способна полностью охарактеризовать качество рекомендательной системы
, .3. Основные результаты
Все тринадцать методов оценивались по единому протоколу с порогом релевантности 4.0 (оценки ≥ 4.0 считаются релевантными), top-N = 10, числом оцениваемых пользователей n = 6348. Время inference измерялось с предварительным прогревом (5 итераций) и усреднялось по 50 последовательным запросам, что обеспечивает воспроизводимость замеров и исключает эффекты первичной загрузки модели
.Для демонстрации результатов было разработано веб-приложение на языке Python с использованием библиотек для работы с рекомендательными системами — PyTorch, scikit-surprise, pandas, NumPy, scikit-learn. Также была использована исследовательская среда Jupyter Notebooks и реализовано серверное приложение на FastAPI, чтобы устранить необходимость переписывания кода моделей при переходе от экспериментов к production. Вычисленные в программном комплексе метрики приведены в таблице 1.
Сводные результаты сравнительного эксперимента (тестовая выборка)
Метод | RMSE | MAE | NDCG@10 | P@10 | R@10 | MRR | Cover. | Divers. | Infer |
GlobalMean | 1,048 | 0,824 | 0,0670 | 0,0514 | 0,0519 | 0,134 | 1,95% | 0,770 | 0,38 |
UserMean | 0,967 | 0,740 | 0,0670 | 0,0514 | 0,0519 | 0,134 | 1,95% | 0,770 | 0,39 |
ItemMean | 0,970 | 0,748 | 0,0004 | 0,0004 | 0,0001 | 0,001 | 0,23% | 0,875 | 0,39 |
Popularity | 2,298 | 2,075 | 0,0670 | 0,0514 | 0,0519 | 0,134 | 1,95% | 0,770 | 0,38 |
User-KNN | 1,031 | 0,805 | 0,0041 | 0,0031 | 0,0027 | 0,011 | 5,02% | 0,823 | 46,1 |
Item-KNN | 1,031 | 0,805 | 0,0039 | 0,0029 | 0,0025 | 0,010 | 6,72% | 0,819 | 98,1 |
TruncatedSVD | 2,991 | 2,793 | 0,0859 | 0,0671 | 0,0718 | 0,171 | 14,45% | 0,778 | 1,23 |
FunkSVD | 0,843 | 0,639 | 0,0046 | 0,0040 | 0,0033 | 0,012 | 6,99% | 0,747 | 46,7 |
NMF | 0,935 | 0,714 | 0,0060 | 0,0049 | 0,0043 | 0,015 | 13,27% | 0,784 | 44,2 |
NCF (NeuMF) | – | – | 0,0921 | 0,0719 | 0,0741 | 0,179 | 14,34% | 0,776 | 6,94 |
Content-Based | – | – | 0,0131 | 0,0086 | 0,0118 | 0,031 | 36,19% | 0,279 | 5,21 |
Hybrid (SVD+CB) | 0,843 | 0,639 | 0,0089 | 0,0076 | 0,0075 | 0,020 | 27,0% | 0,698 | 43,0 |
HybridSVD Emb | 0,838 | 0,635 | 0,0565 | 0,0421 | 0,0422 | 0,123 | 30,55% | 0,700 | 47,7 |
Как видно метод FunkSVD имеет почти минимальную ошибку RMSE – 0,843, но его качество ранжирования (NDCG@10 = 0,0046) хуже большинства методов.
NCF, напротив, лидирует по качеству ранжирования (NDCG@10 = 0,0921) и точности (P@10=0,0719). Поэтому возникла идея объединить эти два метода в ансамбль.
HybridSVD Emb занимает сбалансированную позицию: минимальная ошибка 0,838, средний результат по ранжированию и широкий охват каталога — свыше 30%. Но медленно работает — 47,7 мс. Поэтому его тоже объединяем с NCF, как самым точным и достаточно быстрым.
В итоге получаем следующих кандидатов для создания ансамбля:
1) NCF + FunkSVD;
2) NCF + HybridSVD Emb.
4. Обсуждение
Сравнительный анализ 13 методов показал важную принципиальную идею: ни один одиночный метод не лидирует сразу по всем метрикам.
Группа baseline-методов выполняет роль точки отсчёта: Popularity с NDCG@10 = 0,0670 — минимальная планка, ниже которой опускаться нельзя. ItemKNN при этом служит поучительным примером того, как хорошее значение RMSE вообще ничего не говорит о качестве ранжирования. KNN-методы не смогли реализовать свой потенциал и уступили даже baseline — сказались ограничения обучающей выборки.
Среди методов факторизации картина неоднородная. FunkSVD — абсолютный лидер по точности предсказания рейтингов (RMSE = 0,843), но самостоятельно ранжирует слабо (NDCG@10 = 0,0046). Это не делает его бесполезным: нормализованные результаты FunkSVD несут коллаборативный сигнал на основе явных оценок, которого нет у NCF. Два метода не конкурируют, а дополняют друг друга, поэтому они являются оптимальными кандидатами для включения в ансамбль.
NCF с NDCG@10 = 0,0921 — лучший по ранжированию, при этом компактный и быстрый (inference = 6,94 мс.), но рейтинговых предсказаний не даёт и охватывает узкую часть каталога (14,3%). Преимуществом NCF является нелинейная архитектура, которая позволяет отслеживать сложные паттерны взаимодействия, что недоступно линейным моделям. Поэтому логично рассматривать его как универсальную основу для ансамблей.
HybridSVD Emb выделяется своей стабильностью: он не лидирует ни по одной метрике, зато нигде «не проваливается». RMSE = 0,838, NDCG@10 = 0,0565, Coverage = 30,55% — редкое сочетание точности и охвата. Оба его сигнала — рейтинговый и семантический — получены из одного латентного пространства, что обеспечивает их согласованность. В паре с NCF он способен расширить охват каталога и ослабить эффект фильтрационного пузыря.
Таким образом, в результате проведенного сравнительного анализа рекомендательных алгоритмов были составлены два ансамбля:
1) NCF + FunkSVD — ставка на точность: гипотеза в том, что рейтинговый сигнал FunkSVD корректирует «одинаковость» мест в NCF‑ранжировании и поднимает релевантные фильмы выше;
2) NCF + HybridSVD Emb — ставка на баланс: широкий Coverage второго компонента должен снизить концентрацию рекомендаций на узком подмножестве каталога.
Прежде чем объединять score двух моделей, необходимо решить фундаментальную проблему: NCF возвращает вероятности взаимодействия в диапазоне [0, 1] (выход Sigmoid-активации), тогда как FunkSVD — предсказанные рейтинги в диапазоне приблизительно [0.5, 5.0], а HybridSVD Emb — взвешенную сумму нормализованного SVD-рейтинга и косинусного сходства в собственном диапазоне. Прямое сложение score с разными масштабами бессмысленно: даже при α = 0,5 одна модель будет доминировать только в силу большей абсолютной амплитуды своих значений.
Для решения этой проблемы применяется пользовательская min-max нормализация – каждый вектор score приводится к диапазону [0, 1] отдельно для каждого пользователя и отдельно для каждой модели:
где C(u) — множество фильмов-кандидатов для пользователя u (все фильмы из обучающего каталога, исключая уже просмотренные). Пользовательская нормализация (в отличие от глобальной) критически важна: она гарантирует, что для каждого конкретного пользователя обе модели вносят сопоставимый вклад независимо от абсолютных значений score. Пользователь с «консервативной» NCF-моделью (узкий диапазон вероятностей) и пользователь с «экспрессивной» (широкий диапазон) получают одинаково значимый вклад от обеих моделей.
Дальнейшее объединение алгоритмов в ансамбль возможно с использованием как линейной взвешенной комбинации нормализованных скоров, так и двухэтапного ранжирования (Rerank). Авторами был выбран второй способ, поскольку взвешенная сумма имеет существенное ограничение: она вычисляет score для всего каталога с одинаковым весом α, не учитывая, что наиболее уверенные предсказания NCF уже достаточно точно выявили топ-кандидатов. Двухэтапное ранжирование исправляет это: вычислительные ресурсы второй модели направляются туда, где они принесут наибольшую пользу – на уточнение порядка внутри уже отобранного множества кандидатов.
Алгоритм Rerank работает в два последовательных этапа. На первом этапе NCF-модель формирует расширенный кандидатный список: для пользователя u вычисляются NCF-score для всего каталога и отбираются топ-200 фильмов (K = 200) с наивысшими значениями. Параметр K = 200 выбран из соображений баланса: он достаточно велик, чтобы не потерять релевантные объекты, которые NCF мог оценить неточно, но достаточно мал, чтобы применение второй модели оставалось быстрым.
На втором этапе для отобранных 200 кандидатов вычисляются score второй модели (FunkSVD или HybridSVD Emb), и финальный ранжирующий score вычисляется, как взвешенная сумма:
Параметр α для каждой конфигурации подобран по NDCG@10 по сетке {0.1, 0.2, ..., 0.9} с помощью методов машинного обучения на валидационной выборке. По результатам подбора оптимальный α для пары NCF+FunkSVD составил 0,9: NCF-сигнал несёт значительно больший вклад (90%), тогда как FunkSVD добавляет лишь 10 % коллаборативного рейтингового сигнала. Предельно максимальное значение α объясняется тем, что FunkSVD в задаче ранжирования слаб именно потому, что его предсказания сосредоточены в узком числовом диапазоне с малой дисперсией между фильмами. Даже небольшой вес (0,1) позволяет этому сигналу «разорвать ничью» между похоже оценёнными NCF-моделью фильмами и корректно переставить их относительно друг друга.
Для пары NCF+HybridSVD Emb оптимальный α = 0,7: HybridSVD Emb самостоятельно имеет хорошее ранжирование (NDCG@10 = 0,0565) и заслуженно получает больший вес (0,3).
Таким образом, подобраны оптимальные значения гиперпараметра α, при котором проведен следующий этап вычислительного эксперимента по получению релевантных результатов работы рекомендательных алгоритмов. Обе ансамблевые конфигурации оценивались на тестовой выборке (190 696 оценок, 6 348 пользователей) по тому же протоколу, что и одиночные методы. Результаты сравнения их ключевых метрик представлены в таблице 2.
Таблица 2 - Результаты оценки ансамблевых конфигураций
Конфигурация | α | NDCG@10 | P@10 | R@10 | MRR | Coverage | Infer(мс) |
NCF (baseline) | – | 0,0921 | 0,0719 | 0,0741 | 0,179 | 14,34% | 6,94 |
FunkSVD | – | 0,0046 | 0,0040 | 0,0033 | 0,012 | 6,99% | 46,7 |
HybridSVD Emb | – | 0,0565 | 0,0421 | 0,0422 | 0,123 | 30,55% | 47,7 |
NCF+FunkSVD Rerank | 0,9 | 0,0976 | 0,0762 | 0,0799 | 0,185 | 13,77% | 57,7 |
NCF+HSVE Rerank | 0,7 | 0,0987 | 0,0765 | 0,0813 | 0,187 | 14,23% | 57,3 |
По полученным результатам видно, что ансамблевые конфигурации превосходят все одиночные алгоритмы по всем метрикам ранжирования, хотя NCF сам по себе является лучшим одиночным методом из тринадцати рассмотренных. Это подтверждает базовую теорему ансамблевого обучения: объединение некоррелированных ошибок улучшает общую точность
. NDCG@10 вырос с 0,0921 (NCF) до 0,0987 (NCF+HSVE Rerank), что соответствует относительному приросту +7,2%. MRR улучшился с 0,179 до 0,187 (+4,5%), что означает, что первый релевантный фильм в среднем появляется на более ранней позиции в рекомендательном списке.5. Заключение
В результате проведенных вычислительных экспериментов и их анализа были получены следующие результаты:
• исследованы и реализованы 13 методов рекомендаций в едином экспериментальном пайплайне, построенном на основе датасета MovieLens 25M с учетом темпорального разбиения данных;
• проведен сравнительный анализ реализованных методов по 9 метрикам, оценивающие точность, качество ранжирования, предсказания рейтинга, охвата каталога и время;
• сформированы две ансамблевые конфигурации на основе нейросетевой коллаборативной фильтрации в сочетании с матричной факторизацией и гибридными методами;
• проведен вычислительный эксперимент по нахождению гиперпараметров для объединения алгоритмов в ансамблевые конфигурации методом двухэтапного ранжирования (Rerank);
• проведен сравнительный анализ одиночных методов и ансамблевых конфигураций по ключевым метрикам, оценивающих качество ранжирования.